ailia LLM の QNN バックエンドを使用して、Qualcomm SoC の NPU で LLM / VLM を高速に推論する方法を説明します。
ailia LLM 1.5.0 以降は Qualcomm SoC の NPU(Hexagon)を使用した高速推論に対応しています。NPU 向けには、llama.cpp とは異なるアイリア社独自の実装を搭載しています。
NPU を使用することで、高速・低消費電力に LLM を実行可能です。テキストの LLM だけでなく、画像を入力する VLM(Vision Language Model)や音声入力にも対応し、NPU で処理できます。また、Snapdragon 7s など、ミドルレンジの端末でも Gemma 4 E2B や E4B を実行可能です。
実測値では、Android 端末上で Prefill を最大 4.2 倍高速化し、Prefill 中の CPU 使用率を 1/30 以下に抑えられます(Snapdragon 8+ Gen 1、2,048 トークン入力時の同端末 CPU 比)。
QNN(Qualcomm AI Engine Direct)は Qualcomm が提供するバックエンド API です。ailia LLM では、llama.cpp のモデル形式である GGUF を、QNN で実行可能な形式に変換することで、NPU での推論を実現しています。
Android の Qualcomm SoC で LLM を実行する主な手法と ailia LLM の比較です。ailia LLM は NPU を使用でき、Gemma 4 を NPU で実行でき、Hexagon v69 以降の比較的古い SoC にも対応します。
| 手法 | NPU 対応 | Gemma 4 対応 | 対応 SoC(Android) | 備考 |
|---|---|---|---|---|
| llama.cpp | × | ○ | 制約なし(CPU 実行) | CPU 実行です。実験的な Hexagon バックエンドがありますが、NPU 側のライブラリ(Skel)が署名されていないため一般の端末では実行できません。画像エンコーダは CPU で実行されます。 |
| QNN(Qualcomm AI Engine Direct) | ○ | × | Hexagon v65 以降(Snapdragon 845 以降) | 低レベルの推論 API で、LLM のランタイムは提供されません。 |
| QNN GenAI(Qualcomm Genie / GenieX) | ○ | × | Hexagon v79 以降(Snapdragon 8 Elite 以降) | 公式の対応 Android SoC は Snapdragon 8 Elite 系のみで、Hexagon v79 以降が必須です。Gemma 4 の NPU 用(QAIRT)モデルは提供されていません。 |
| LiteRT-LM NPU | ○ | × | Snapdragon 8 Gen 2 / 8 Gen 3 / 8 Elite(SM8550 / SM8650 / SM8750) | Qualcomm 向けに公開されている NPU モデルは Gemma3-1B(4bit、コンテキスト長 1,280)のみです。Gemma 4 の NPU モデルは Google Tensor と Intel 向けにのみ提供されています。テキスト専用で、画像・音声入力には対応していません。 |
| ailia LLM | ○ | ○ | Hexagon v69 以降(Snapdragon 8 Gen 1 以降、7s Gen 3 など) | Snapdragon 8+ Gen 1 などの古い SoC でも NPU を使用でき、Gemma 4 E2B / E4B をテキスト・VLM・ALM とも NPU で実行できます。Int16 への量子化に対応しており、FP16 に非対応の Snapdragon 7s でも実行可能です。 |
GGUF を PC 上で QNN Model に変換し、変換済みの QNN Model を端末上の ailia LLM で実行します。端末側では GGUF は不要で、QNN Model のみを配置します。
QNN Model は Prefill 用の固定長グラフ(AR-N)と Decode 用のグラフ(AR-1)を同じ QNN Context に格納し、重みと KV キャッシュを共有します。重みは変換時に 4bit(W4)に量子化され、FP16 モデルでは活性値と KV キャッシュは FP16 で処理されます。
ailia LLM Compiler は FP16 と Int16 の両方に対応しており、対象の SoC に応じて変換時に切り替えられます。Snapdragon 7s Gen 3 の NPU は Hexagon v73 ですが、FP16 に対応していないため、ailia LLM では Int16 に量子化したモデルを使用します。Qualcomm の Snapdragon 7s Gen 3 製品資料(PDF、2 ページの Artificial Intelligence)では、NPU の対応精度として INT4、INT8、INT16 が記載されており、FP16 は含まれていません。Hexagon のバージョンだけでなく、SoC ごとの対応精度に合わせてモデルを選択してください。
現在は Gemma 4 E2B と Gemma 4 E4B(いずれもテキスト・画像・音声入力)に対応しています。画像・音声入力では、テキスト用の QNN Model に加えて、画像 / 音声エンコーダ(mmproj)の QNN Model を使用します。対応するモデルは SoC の Hexagon バージョンによって異なります。
| Hexagon バージョン | SoC の例 | 対応モデル | コンテキスト長 |
|---|---|---|---|
| v68(Experimental) | QCS6490 | Gemma 4 E2B | 8K |
| v69 | Snapdragon 8 Gen 1 / 8+ Gen 1 | Gemma 4 E2B | 8K |
| v73 以降 | Snapdragon 7s Gen 3、8 Gen 2 以降 | Gemma 4 E2B / E4B | 8K |
QNN Model はモデルと Snapdragon の機種(SoC)ごとに別ファイルになります。変換済みのモデルファイルを提供していますので、対象端末の SoC に対応したファイルをご利用ください。
| ファイル | 内容 |
|---|---|
gemma4-<model>-<soc>.qnn(例: gemma4-e2b-sm8475.qnn) | テキストモデル(Prefill + Decode) |
gemma4-<model>-<soc>-mmproj.qnn(例: gemma4-e2b-sm8475-mmproj.qnn) | 画像 / 音声エンコーダ(mmproj) |
変換済みの Gemma 4 の QNN Model は下記からダウンロードできます。VLM / 音声入力を使用する場合は、テキストモデルと mmproj の両方をダウンロードしてください。E4B は Hexagon v73 以降のみ対応です。
| SoC | 端末の例 | モデル | ファイル | 内容 | サイズ |
|---|---|---|---|---|---|
| sm8475 (Hexagon v69 / FP16) | Snapdragon 8+ Gen 1 | E2B | gemma4-e2b-sm8475.qnn | テキストモデル(Prefill + Decode) | 3.60 GB |
| gemma4-e2b-sm8475-mmproj.qnn | 画像 / 音声エンコーダ(mmproj) | 1.10 GB | |||
| sm7635 (Hexagon v73 / Int16) | Snapdragon 7s Gen 3 | E2B | gemma4-e2b-sm7635.qnn | テキストモデル(Prefill + Decode) | 3.56 GB |
| gemma4-e2b-sm7635-mmproj.qnn | 画像 / 音声エンコーダ(mmproj) | 0.63 GB | |||
| E4B | gemma4-e4b-sm7635.qnn | テキストモデル(Prefill + Decode) | 5.54 GB | ||
| gemma4-e4b-sm7635-mmproj.qnn | 画像 / 音声エンコーダ(mmproj) | 0.64 GB | |||
| qcs6490 (Hexagon v68 / Int16) Experimental | QCS6490 | E2B | gemma4-e2b-qcs6490.qnn | テキストモデル(Prefill + Decode) | 3.60 GB |
| gemma4-e2b-qcs6490-mmproj.qnn | 画像 / 音声エンコーダ(mmproj) | 0.63 GB |
いずれも ailia LLM 1.5.0(QAIRT 2.47.0.260601)向けで、コンテキスト長は 8192、AR-256 / AR-1 構成です。
ailiaLLMGetQNNModelName API で取得できる名称)をお知らせいただければ、ailia LLM Compiler で該当 SoC 向けの QNN Model をコンパイルいたしますので、ailia までお問い合わせください。
ailiaLLMGetQNNModelName API で取得できます(例: "sm8475")。
libailia_llm.so に加えて、libailia_llm_qnn.so をアプリケーションの jniLibs/arm64-v8a に同梱します。アプリ側がロードするのは libailia_llm.so のみで、QNN Model を開いたときにだけ libailia_llm_qnn.so がプラグインとして遅延ロードされます。
libcdsprpc.so の使用を AndroidManifest.xml に記載する必要があります。また、NPU 側のライブラリ(libQnnHtpV*Skel.so)をファイルシステム経由で参照するため、extractNativeLibs を有効にします。
<application android:extractNativeLibs="true" ...>
    <uses-native-library android:name="libcdsprpc.so" android:required="false"/>
</application>
build.gradle に下記を追加すると、QNN ランタイムが自動的に apk に同梱されます。
implementation 'com.qualcomm.qti:qnn-runtime:2.47.0'QNN Model(.qnn)は GGUF と同じモデル読み込み API に渡します。コンテキスト長に 0 を指定すると、QNN Model に埋め込まれた固定のコンテキスト長が使用されます。画像・音声入力を使用する場合は、テキストモデルを開いた後に mmproj の QNN Model をプロジェクタとして開きます。
#include "ailia_llm.h"
struct AILIALLM *llm = nullptr;
ailiaLLMCreate(&llm);
ailiaLLMOpenModelFileA(llm, "gemma4-e2b-sm8475.qnn", /*ctx_size=*/0);
ailiaLLMOpenMultimodalProjectorFileA(llm, "gemma4-e2b-sm8475-mmproj.qnn"); // 画像・音声入力のみ
// 以降は GGUF と同じ prompt / generate API を使用します
ailiaLLMDestroy(llm);
Kotlin(JNI)でも同様に、GGUF のパスの代わりに QNN Model のパスを渡します。
val llm = AiliaLLM()
llm.openModelFile(qnnModelPath, 0)            // n_ctx=0 で QNN Model 内の固定長を使用
llm.openMultimodalProjectorFile(mmprojQnnPath) // 画像・音声入力のみAndroid 向けの評価版 apk は下記からダウンロードできます。QNN 対応版は ailia-models-kotlin-qnn.apk です。
https://github.com/ailia-ai/ailia-models-kotlin/releases/tag/v260927
ailia LLM は QNN Model を mmap で読み込み、QNN Context を復元して Hexagon NPU(HTP)上で実行します。Prefill は固定長の AR-N グラフで処理し、プロンプトが AR の倍数でない場合は最後のスライスをパディングします。Decode は同じ Context 内の AR-1 グラフで処理し、Prefill 後の KV キャッシュのコピーは発生しません。VLM では画像のパッチ化と位置埋め込みを CPU で行い、16 層の Vision Transformer からプーリング、プロジェクションまでを 1 つの QNN グラフで実行します。音声入力には Audio グラフを使用し、音声エンコーダを NPU で実行します。また、層別トークン埋め込み(PLE)のフロントエンドも各 Transformer グラフ内で実行し、CPU 側にはトークン行の参照とメディア埋め込みの差し替えのみを残しています。これにより、入力処理を CPU で行う場合に比べて Int16 モデルの Prefill が改善します。
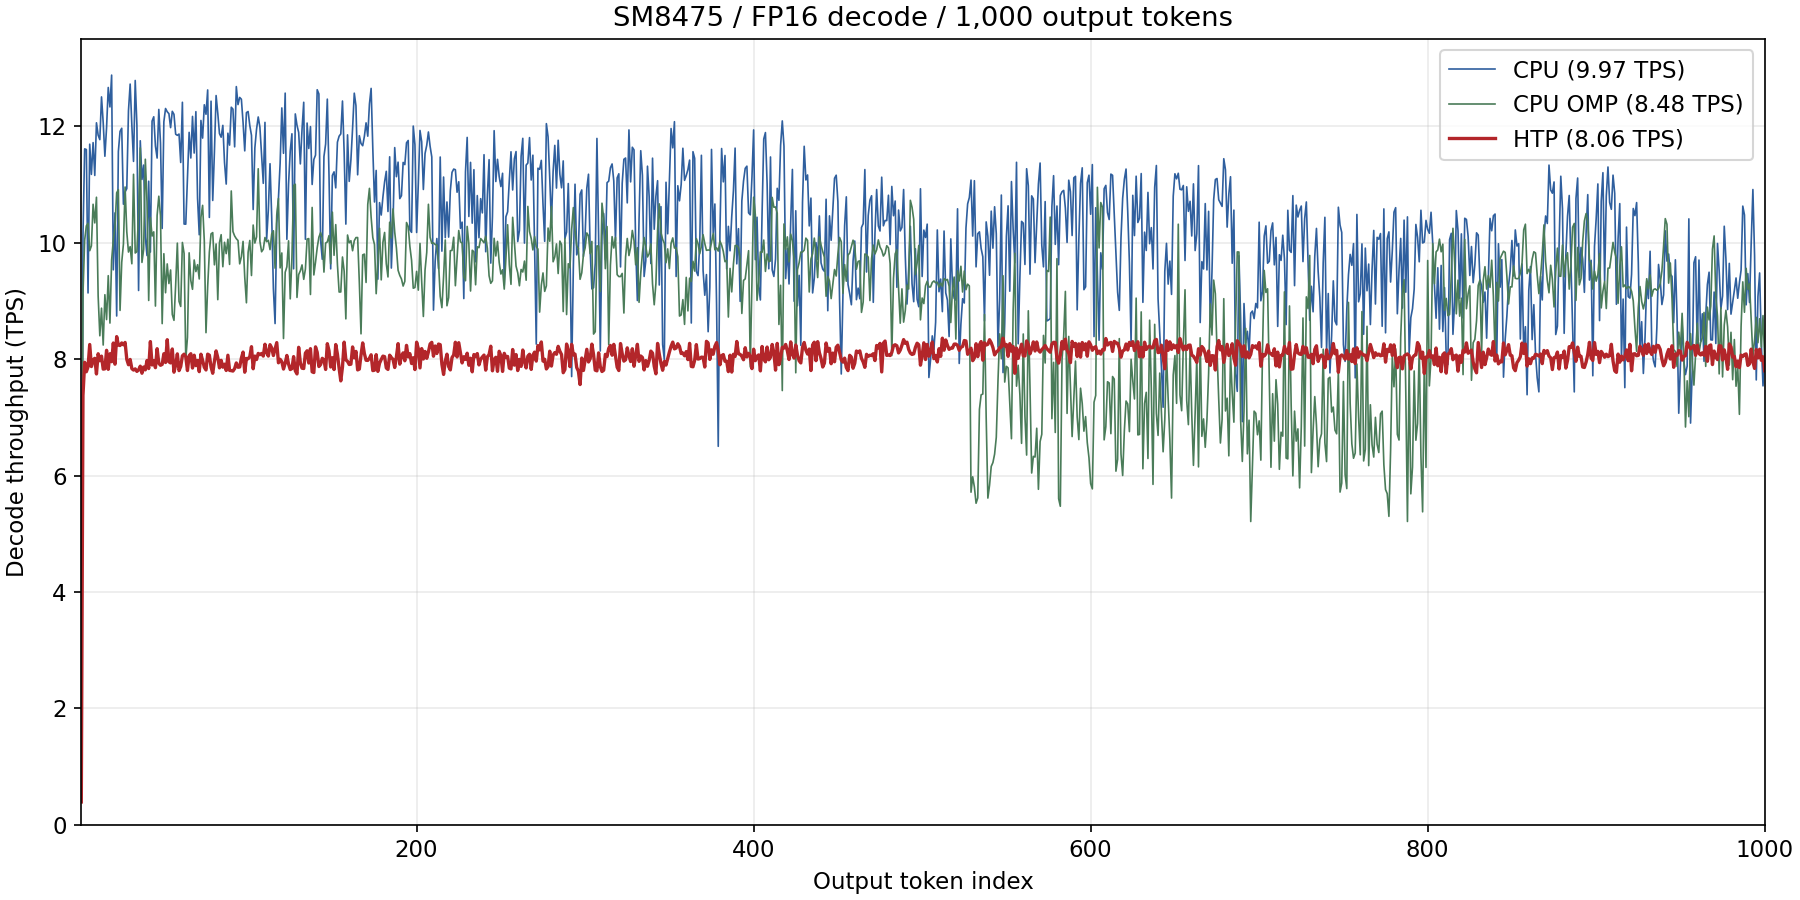
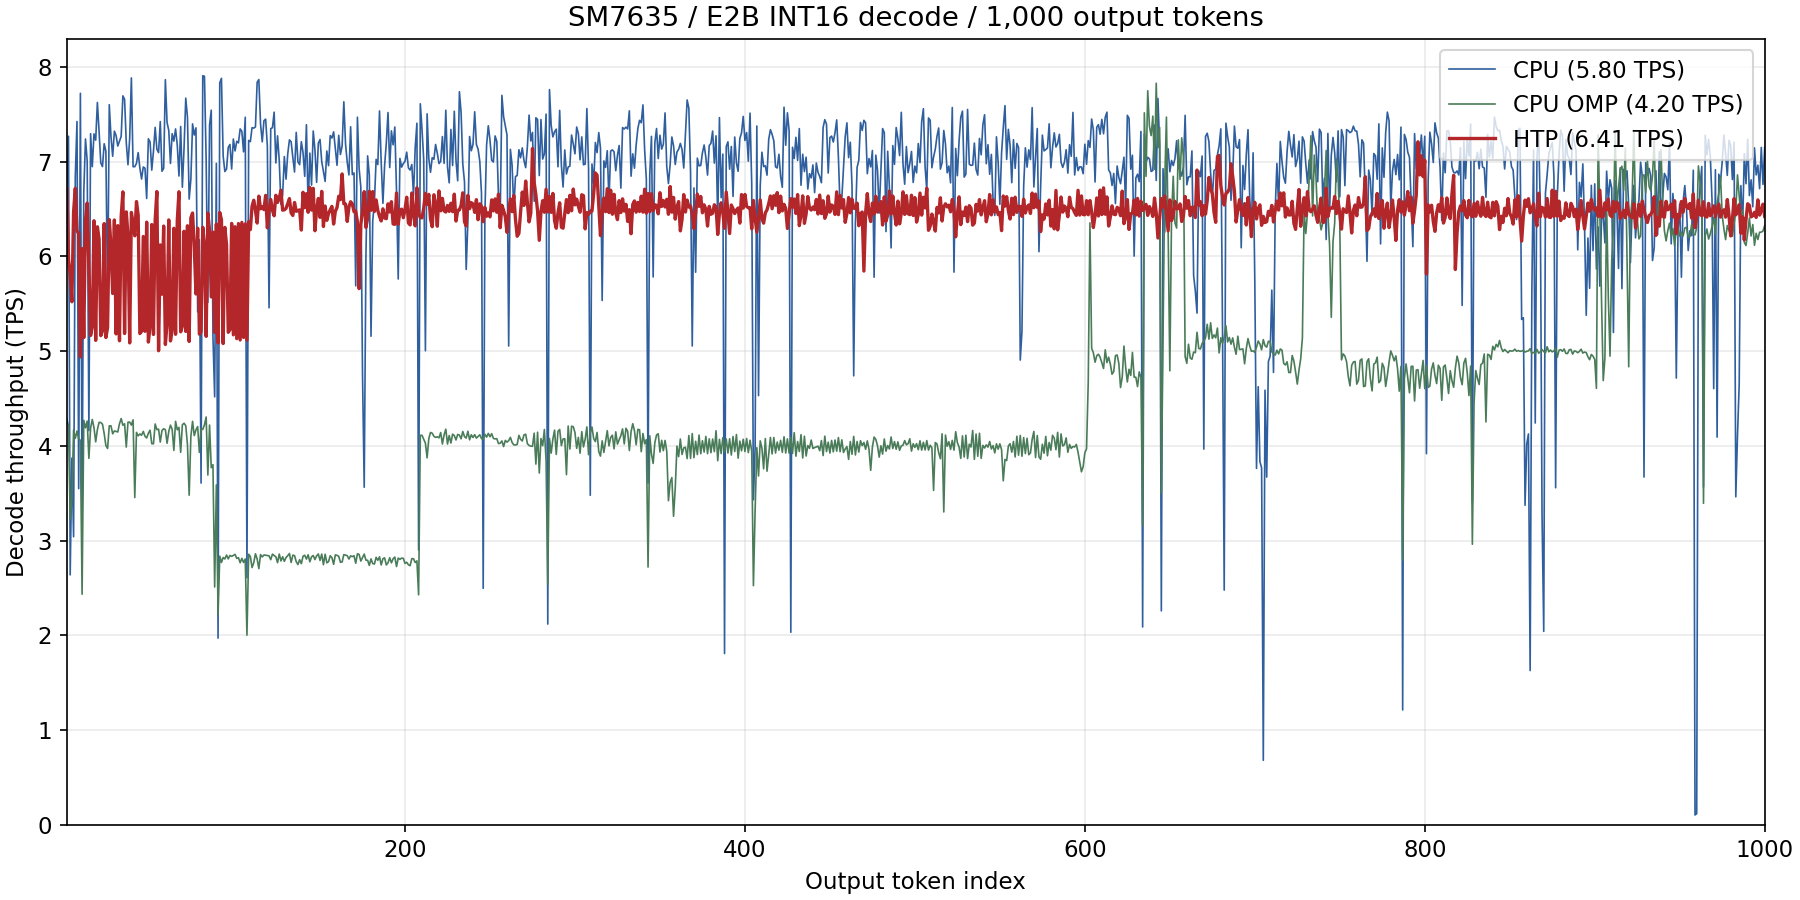
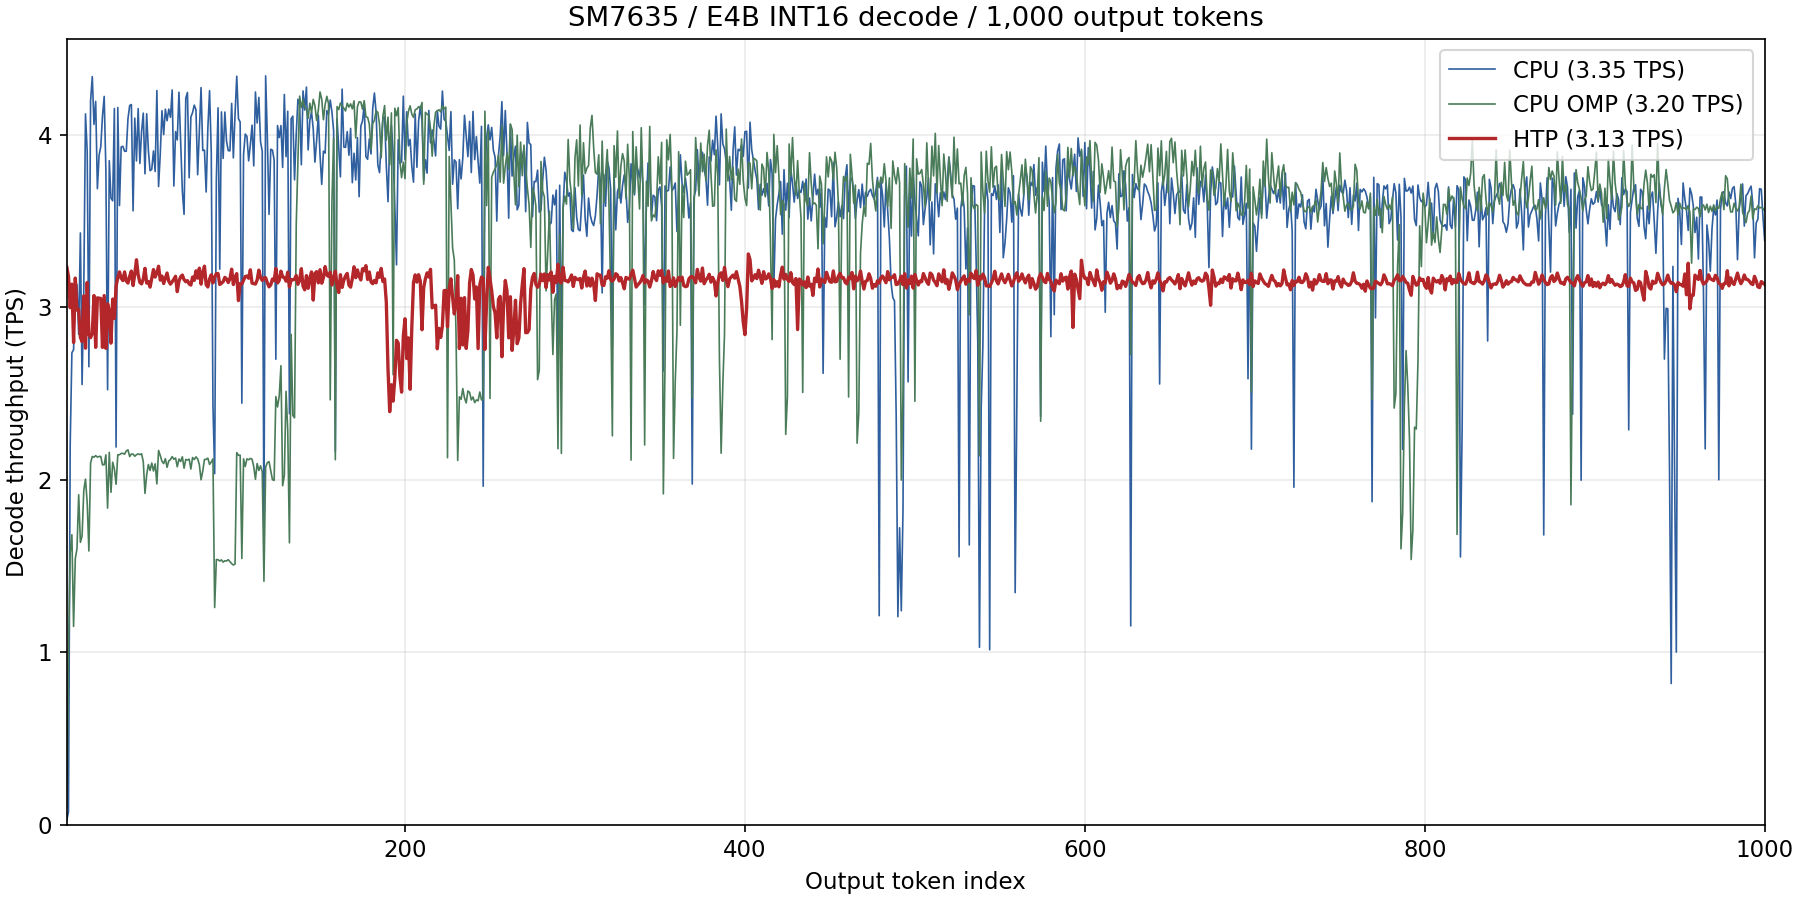
Gemma 4 を 2 機種で測定した結果です。Snapdragon 8+ Gen 1(SM8475 / Hexagon v69)は E2B の FP16 モデル、Snapdragon 7s Gen 3(SM7635 / Hexagon v73)は E2B / E4B の Int16 モデルを使用しています。いずれも QAIRT 2.47、コンテキスト長 8192、AR-256 / AR-1 構成です。
CPU は同じ端末上で、同一の Q4_0 GGUF を標準の llama.cpp 経路で実行した値です(デコーダワーカー 8、コンテキスト 8192)。出荷構成は OpenMP 無効のビルドで、表の「CPU」がこれにあたります。「CPU(OpenMP)」は GGML_OPENMP=ON / OMP_NUM_THREADS=2 でビルドした比較用の構成です。
81 トークン入力・1,000 トークン生成時のスループットです。
| 端末 | モデル | CPU | CPU(OpenMP) | NPU(QNN) | NPU の効果 |
|---|---|---|---|---|---|
| SM8475(Hexagon v69) | E2B / FP16 | 9.971 tokens/s | 8.482 tokens/s | 8.062 tokens/s | 0.81 倍 |
| SM7635(Hexagon v73) | E2B / Int16 | 5.805 tokens/s | 4.195 tokens/s | 6.410 tokens/s | 1.10 倍高速 |
| SM7635(Hexagon v73) | E4B / Int16 | 3.351 tokens/s | 3.203 tokens/s | 3.128 tokens/s | 0.93 倍 |
SM7635 の E2B では NPU の Decode が CPU より 1.10 倍(OpenMP ビルド比では 1.53 倍)高速です。一方、SM8475 の E2B(0.81 倍)と SM7635 の E4B(0.93 倍)では CPU を下回ります。Decode は 1 トークンずつ処理するため重みの読み出しが支配的になり、NPU の並列演算性能を活かしにくいためです。
入力トークン数を 64〜2,048 まで変えたときのスループット(tokens/s)です。2 トークンのウォームアップ後、評価を伴わない SetPrompt を 2 回呼んで KV キャッシュを消去し、各入力長で 1 トークンだけ生成しています。
| 端末・モデル・経路 | 64 | 128 | 256 | 512 | 1024 | 2048 |
|---|---|---|---|---|---|---|
| SM8475 E2B CPU | 109.359 | 95.722 | 88.243 | 85.663 | 79.940 | 71.244 |
| SM8475 E2B CPU(OpenMP) | 54.184 | 55.333 | 61.476 | 60.319 | 55.500 | 51.064 |
| SM8475 E2B NPU(FP16) | 76.244 | 144.406 | 277.775 | 302.667 | 301.791 | 299.827 |
| SM7635 E2B CPU | 91.550 | 77.064 | 80.496 | 76.187 | 69.757 | 59.192 |
| SM7635 E2B CPU(OpenMP) | 27.441 | 49.999 | 62.793 | 70.965 | 69.228 | 56.059 |
| SM7635 E2B NPU(Int16) | 33.601 | 66.523 | 130.329 | 133.404 | 131.367 | 130.252 |
| SM7635 E4B CPU | 1.697 | 29.105 | 28.417 | 62.663 | 64.383 | 60.897 |
| SM7635 E4B CPU(OpenMP) | 6.746 | 27.824 | 40.097 | 61.877 | 66.980 | 54.372 |
| SM7635 E4B NPU(Int16) | 20.304 | 40.890 | 80.700 | 83.758 | 83.314 | 78.258 |
実入力トークン数 / 最初の生成呼び出し時間 です。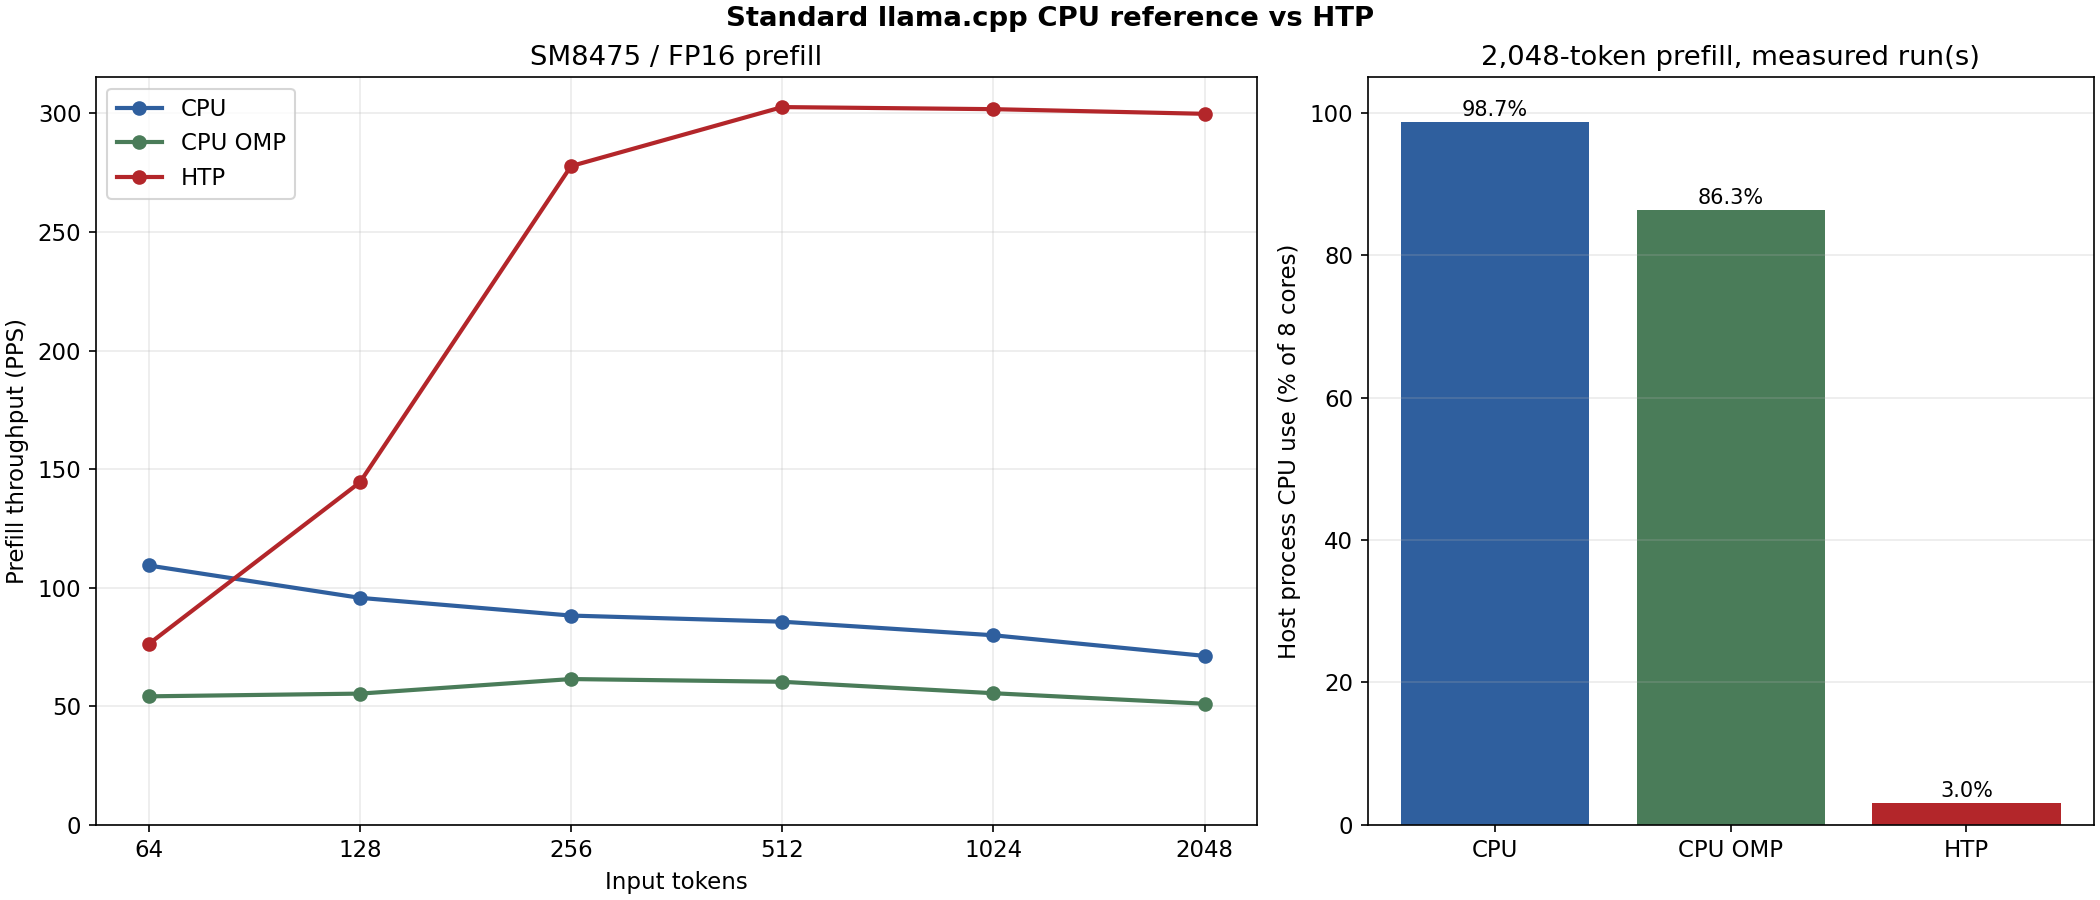
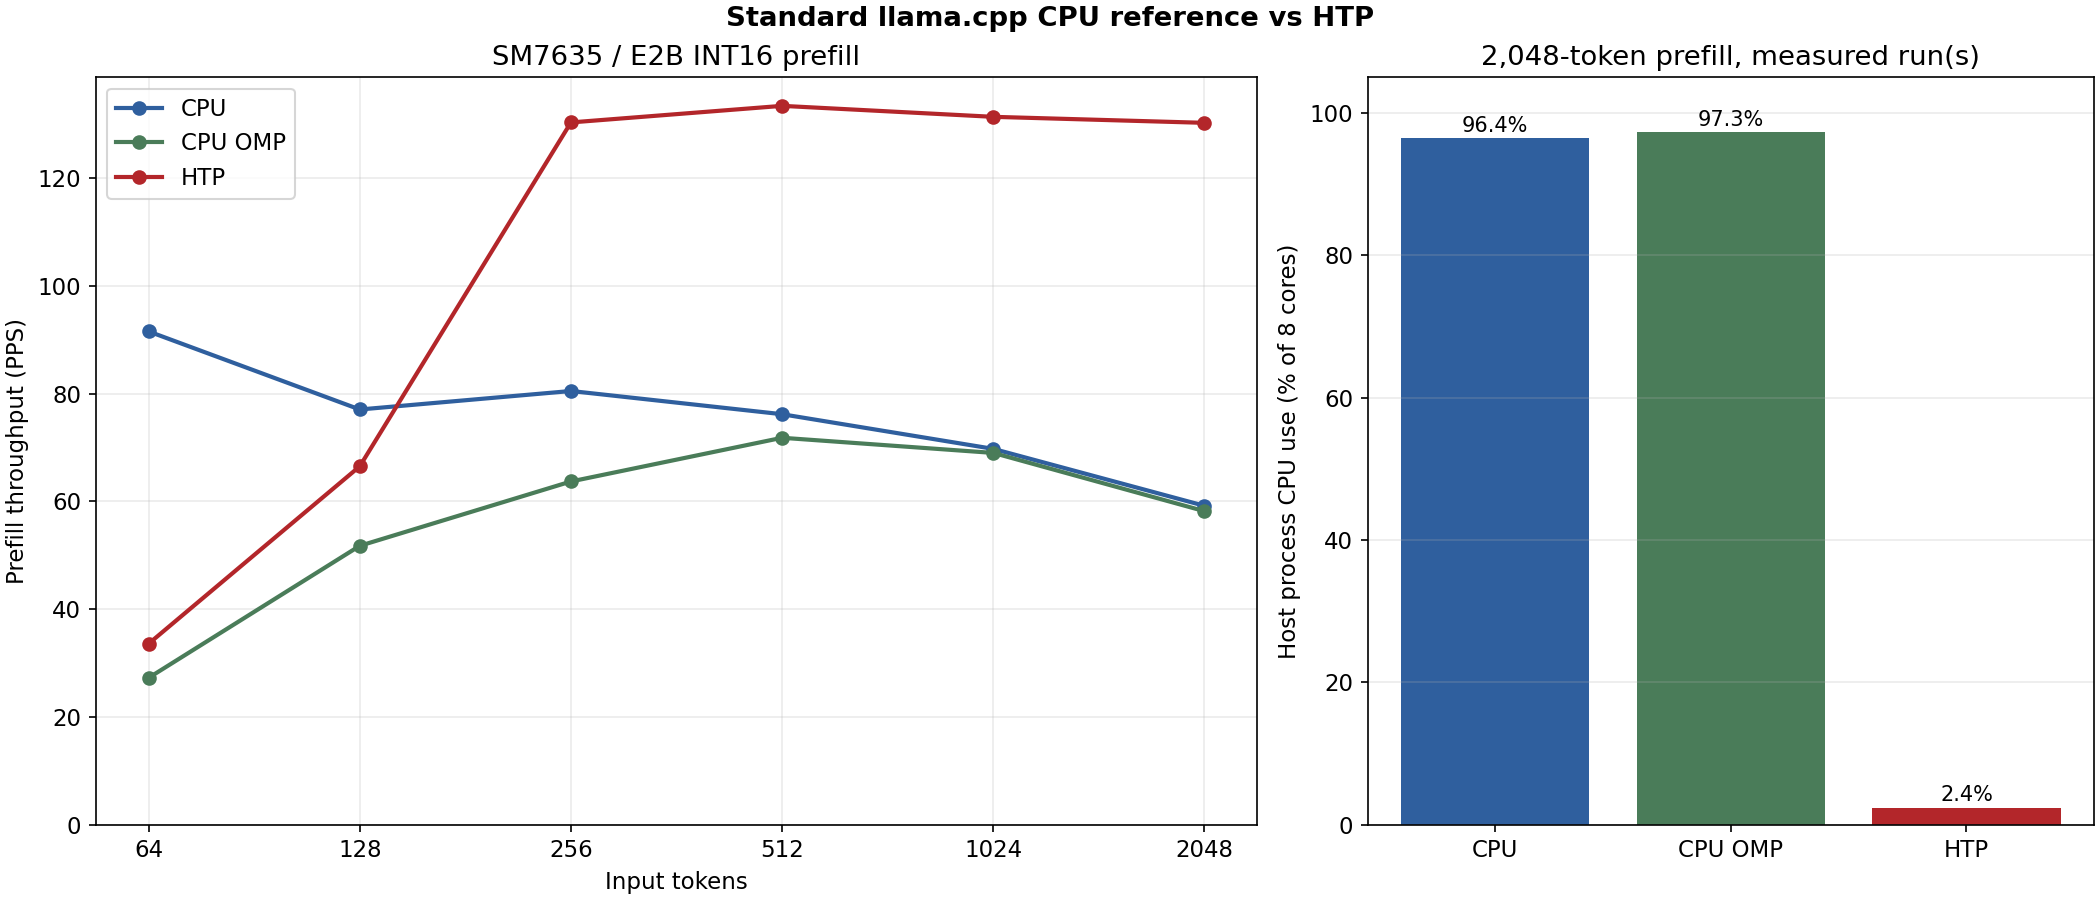
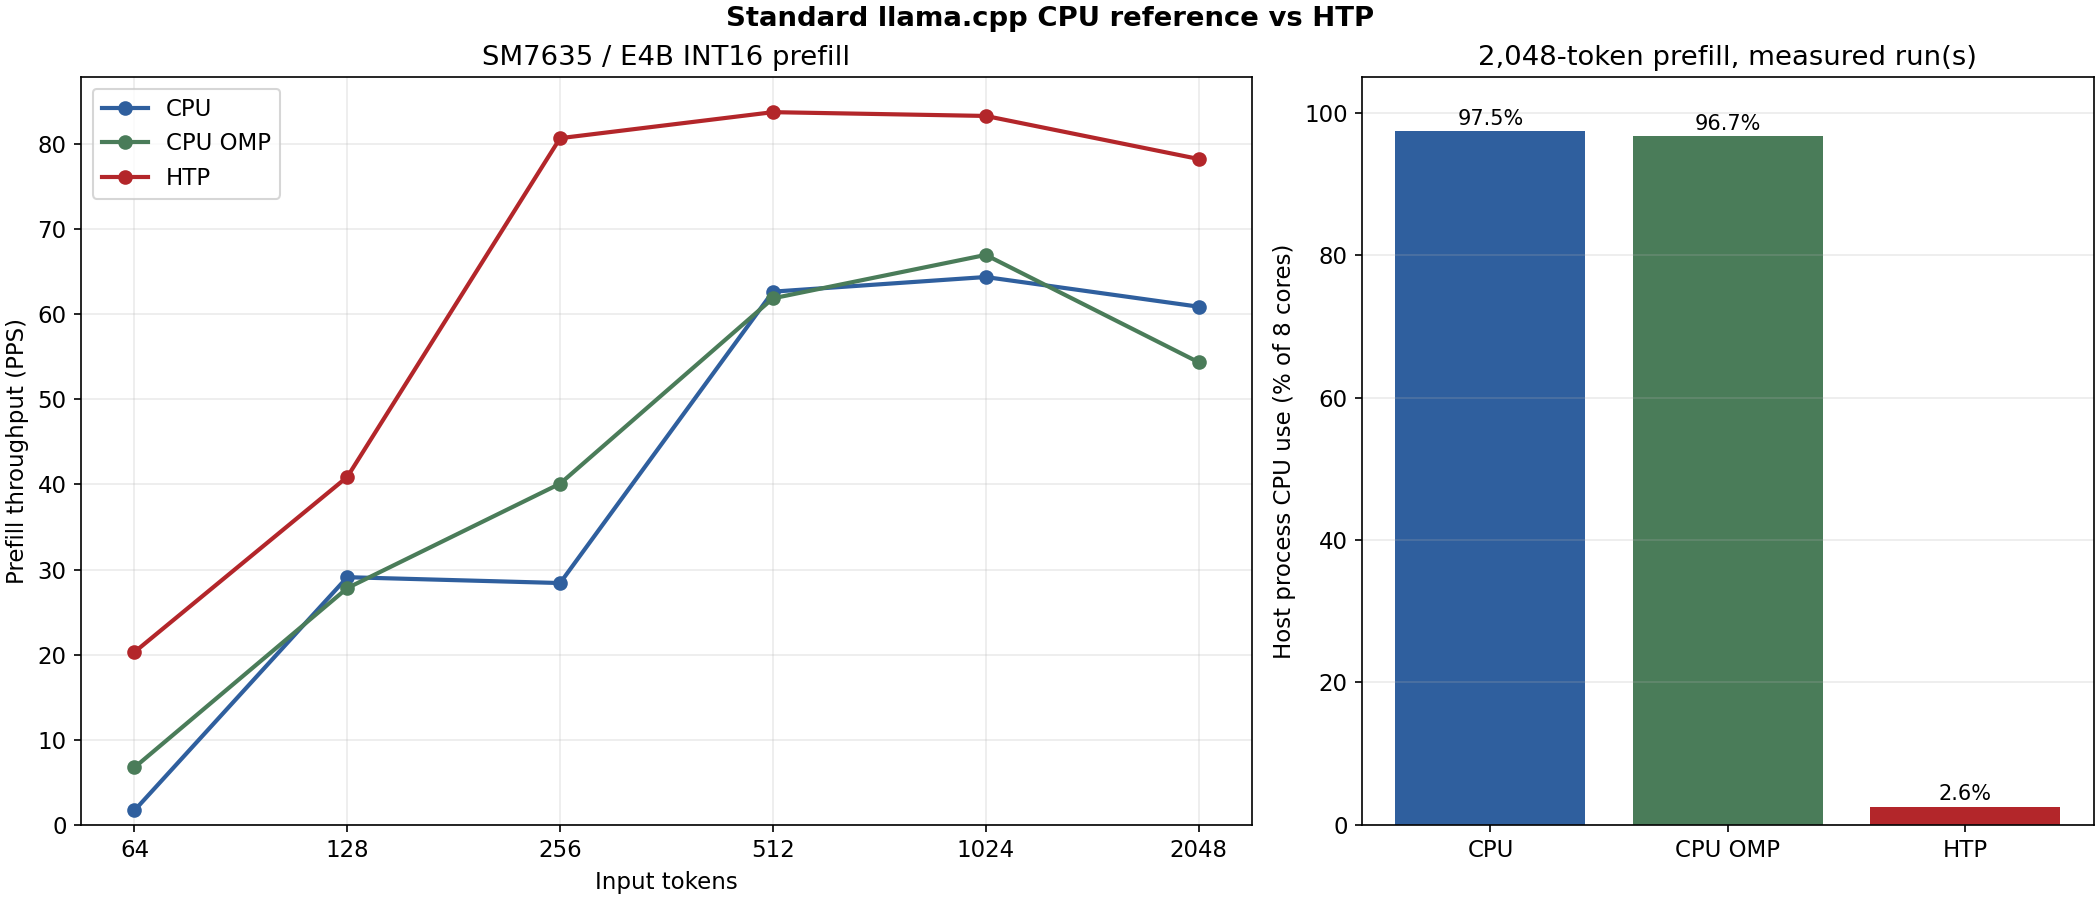
2,048 トークン Prefill における、最初の生成呼び出し前後のプロセス CPU 時間です。8 コアすべてを使い切った状態を 100% として表しています。アプリケーションプロセスの使用率であり、端末全体の使用率ではありません。
| 端末・モデル | CPU | CPU(OpenMP) | NPU(QNN) |
|---|---|---|---|
| SM8475 E2B | 98.7% | 86.3% | 3.0% |
| SM7635 E2B | 96.4% | 97.3% | 2.4% |
| SM7635 E4B | 97.5% | 96.7% | 2.6% |
NPU では Prefill 中の CPU 使用率が 3% 前後に収まるため、アプリケーション側の処理に CPU を残せます。CPU 実行では 8 コアをほぼ使い切るため、発熱と他処理への影響が大きくなります。
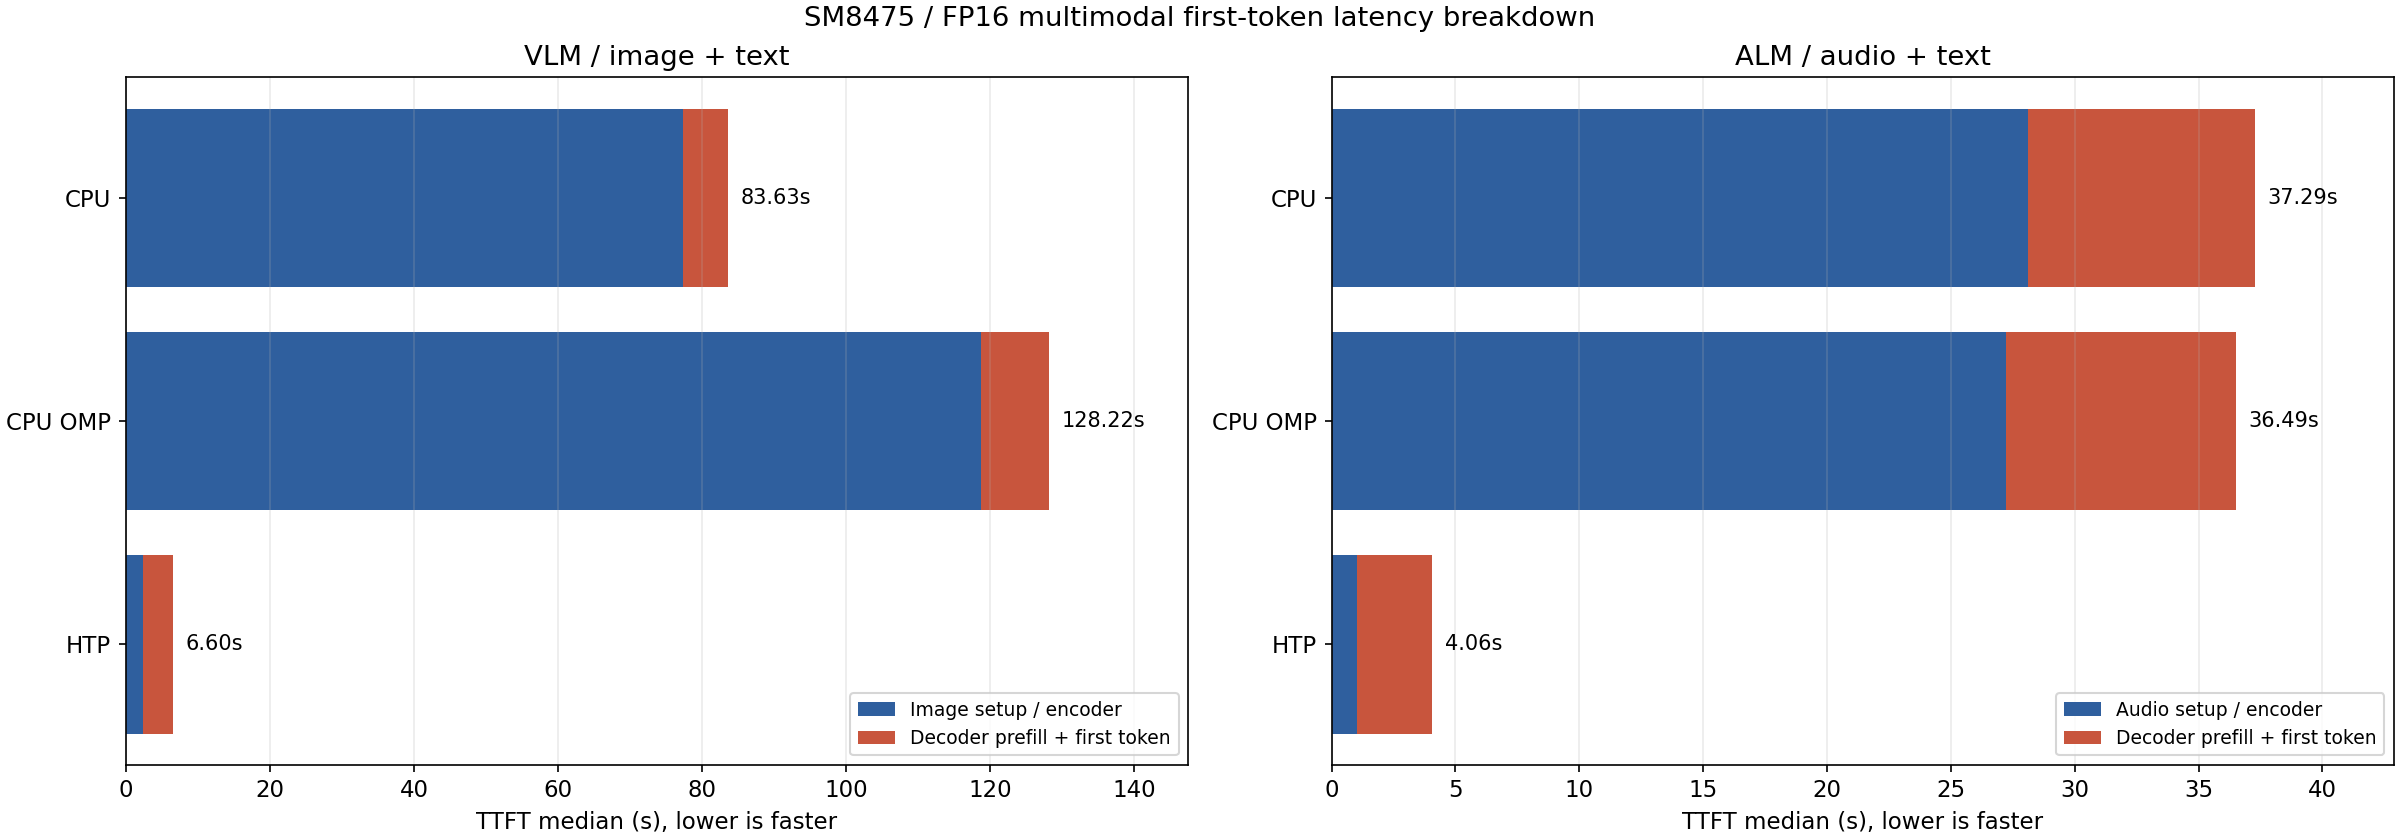
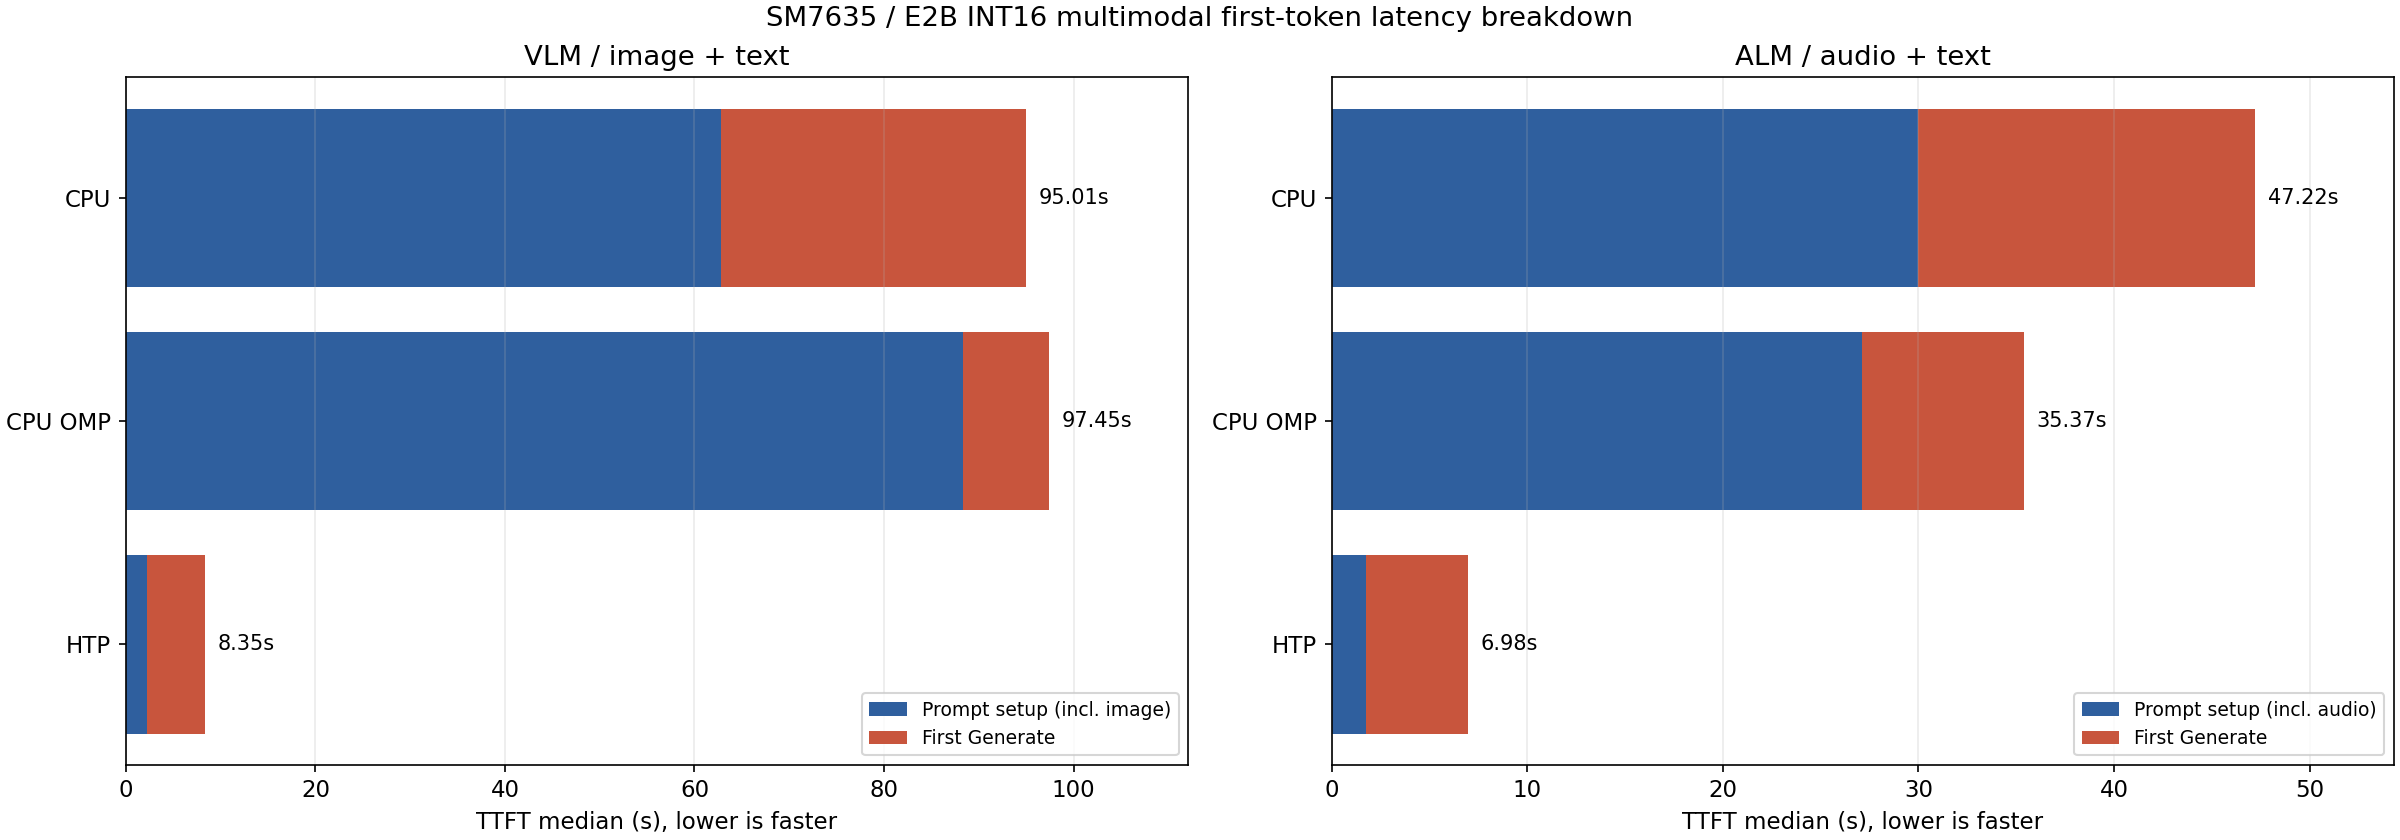
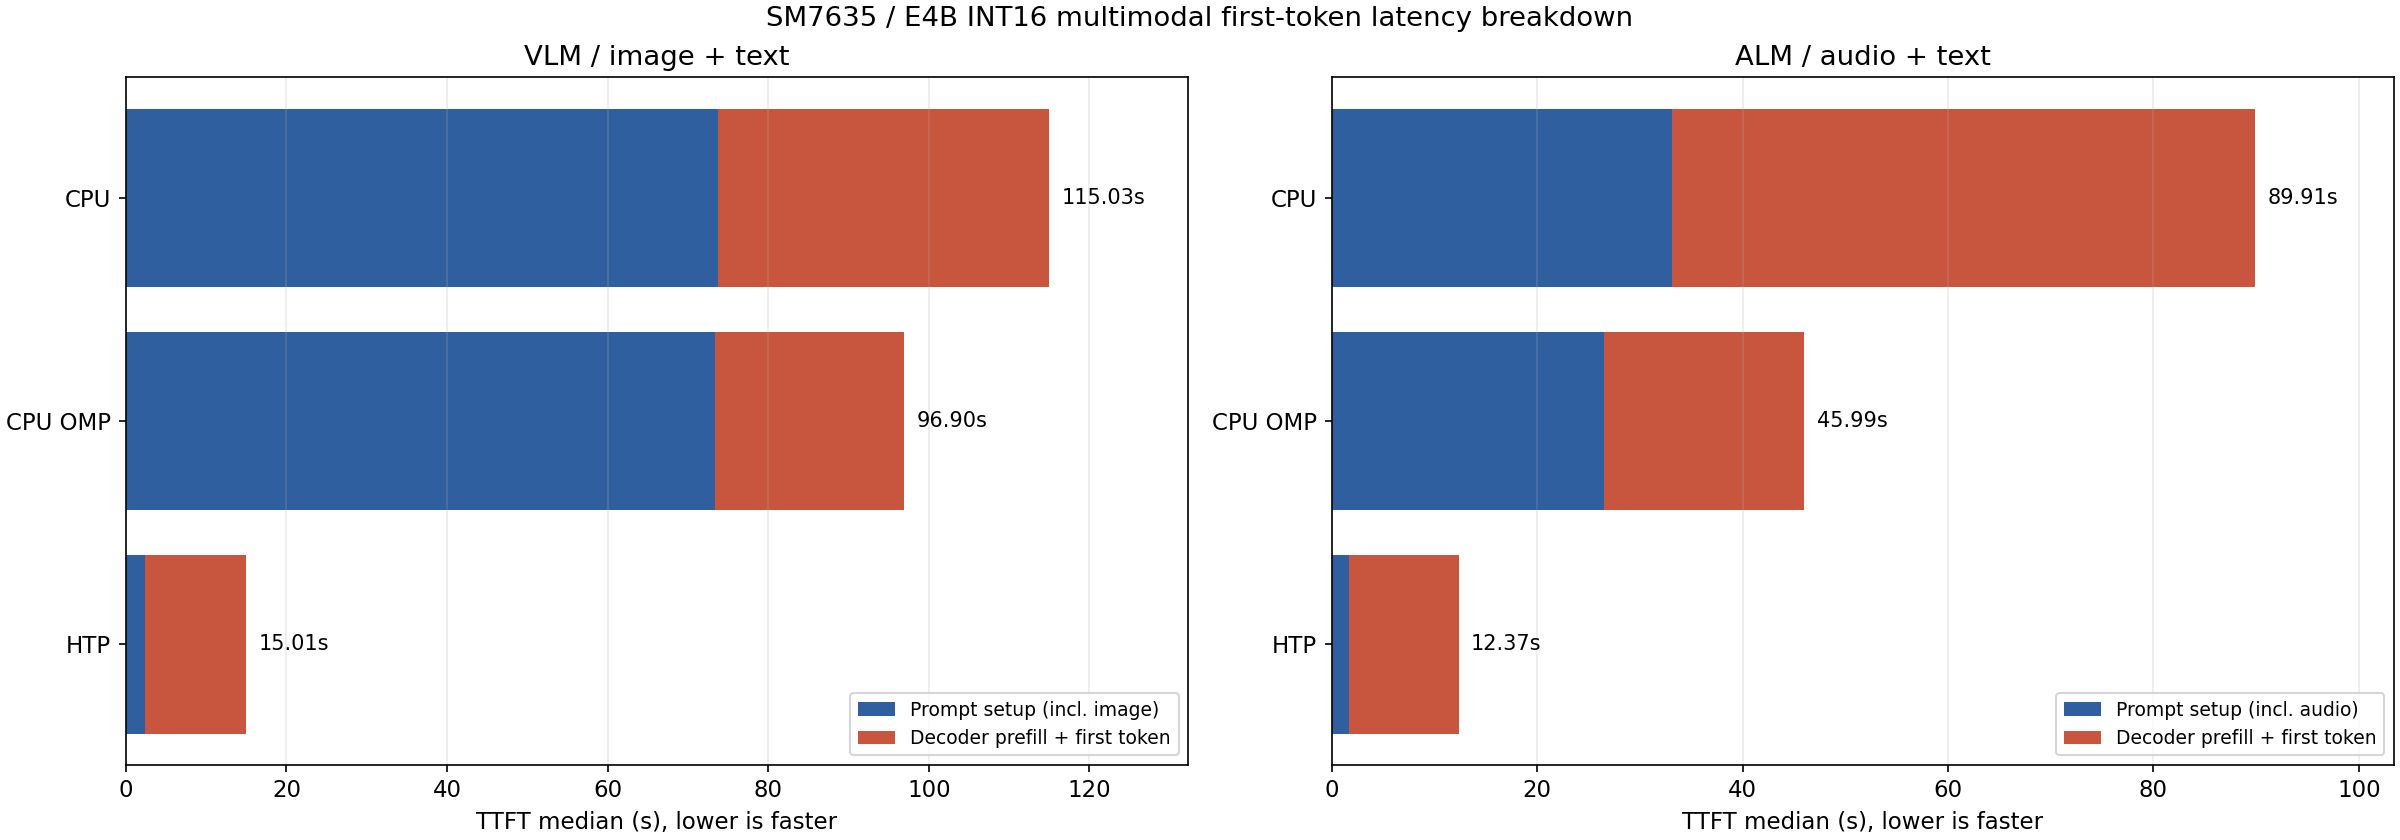
同一の 768x768 画像 10 枚、各 100 トークン出力での中央値です。TTFT は画像エンコーダを含むプロンプト設定と最初の生成呼び出しの合計で、モデルのオープンは含みません。
| 端末・モデル・経路 | TTFT(中央値) | Decode(中央値) |
|---|---|---|
| SM8475 E2B CPU | 83.63 秒 | 12.081 tokens/s |
| SM8475 E2B CPU(OpenMP) | 128.22 秒 | 7.491 tokens/s |
| SM8475 E2B NPU(FP16) | 6.60 秒 | 7.033 tokens/s |
| SM7635 E2B CPU | 95.01 秒 | 5.891 tokens/s |
| SM7635 E2B CPU(OpenMP) | 97.45 秒 | 3.569 tokens/s |
| SM7635 E2B NPU(Int16) | 8.35 秒 | 6.444 tokens/s |
| SM7635 E4B CPU | 115.03 秒 | 3.332 tokens/s |
| SM7635 E4B CPU(OpenMP) | 96.90 秒 | 2.642 tokens/s |
| SM7635 E4B NPU(Int16) | 15.01 秒 | 3.098 tokens/s |
画像入力の TTFT は、SM8475 の E2B で約 12.7 倍、SM7635 の E2B で約 11.4 倍、E4B で約 7.7 倍高速です。CPU と NPU はいずれも同じ 768x768 の画素と 256 個の画像埋め込みを処理しています。
FLEURS の 10 録音(5 言語 各 2 件、自然な EOS まで生成し上限 256 トークン)の中央値です。TTFT は音声エンコーダを含むプロンプト設定と最初の生成呼び出しの合計で、モデルのオープンは含みません。
| 端末・モデル・経路 | TTFT(中央値) | Decode(中央値) | 出力トークン数 |
|---|---|---|---|
| SM8475 E2B CPU | 37.29 秒 | 10.416 tokens/s | 21〜89 |
| SM8475 E2B CPU(OpenMP) | 36.49 秒 | 10.539 tokens/s | 21〜89 |
| SM8475 E2B NPU(FP16) | 4.06 秒 | 6.495 tokens/s | 21〜90 |
| SM7635 E2B CPU | 47.22 秒 | 5.166 tokens/s | 21〜89 |
| SM7635 E2B CPU(OpenMP) | 35.37 秒 | 3.846 tokens/s | 21〜89 |
| SM7635 E2B NPU(Int16) | 6.98 秒 | 6.356 tokens/s | 22〜60 |
| SM7635 E4B CPU | 89.91 秒 | 3.053 tokens/s | 21〜91 |
| SM7635 E4B CPU(OpenMP) | 45.99 秒 | 2.947 tokens/s | 21〜91 |
| SM7635 E4B NPU(Int16) | 12.37 秒 | 3.018 tokens/s | 21〜91 |
音声入力の TTFT は、SM8475 の E2B で約 9.2 倍、SM7635 の E2B で約 6.8 倍、E4B で約 7.3 倍高速です。
E2B は SM7635(Hexagon v73)で、LLM / VLM / ALM の各構成を 8 トークン生成で実行したときのメモリ使用量です(単位 MiB、コンテキスト長 8192)。CPU は Q4_0 GGUF と BF16 の mmproj、NPU は Int16 の QNN Model を使用しています。モデルは mmap で読み込むため、実際に確保した作業メモリである匿名メモリ(RssAnon)と、ページキャッシュとして再利用できるファイルマッピング(RssFile)を分けて記載します。ピークはプロセスの最大常駐サイズ(VmHWM)です。
| モデル | ワークロード | 実行系 | VmHWM | RssAnon | RssFile |
|---|---|---|---|---|---|
| E2B | LLM | CPU | 4574.2 | 1524.1 | 2896.5 |
| E2B | LLM | NPU(Int16) | 1666.8 | 386.4 | 1276.2 |
| E2B | VLM | CPU | 4881.2 | 2512.4 | 40.3 |
| E2B | VLM | NPU(Int16) | 2161.2 | 673.3 | 1483.7 |
| E2B | ALM | CPU | 4873.7 | 2623.0 | 1509.1 |
| E2B | ALM | NPU(Int16) | 2202.5 | 591.6 | 1606.7 |
mallopt(M_PURGE, 0) を呼ぶと 23 MiB 前後になります。E4B は同じ端末で、81 トークン入力・100 トークン出力の LLM を 1 回ずつ実行した参考測定です(単位 MiB)。RssAnon と RssFile の内訳は取得しておらず、実行中の PSS を併記します。E2B の表とは条件が異なります。
| モデル | ワークロード | 実行系 | VmHWM | 実行中の PSS |
|---|---|---|---|---|
| E4B | LLM | CPU | 5569.8 | 4432.7 |
| E4B | LLM | CPU(OpenMP) | 5518.2 | 3922.2 |
| E4B | LLM | NPU(Int16) | 1976.0 | 1801.8 |
E4B でも NPU のピークは CPU の約 3 分の 1 です。この測定は端末が Thermal Status 1 の状態で、Android のページ回収の影響を受けています。