ailia LLM 1.5.0 の QNN バックエンドで Gemma 4 を Qualcomm SoC の NPU で実行した測定結果を、同じ端末の CPU 実行と比較して示します。
QNN バックエンドの使い方は ailia LLM NPU(QNN)ガイド を参照してください。
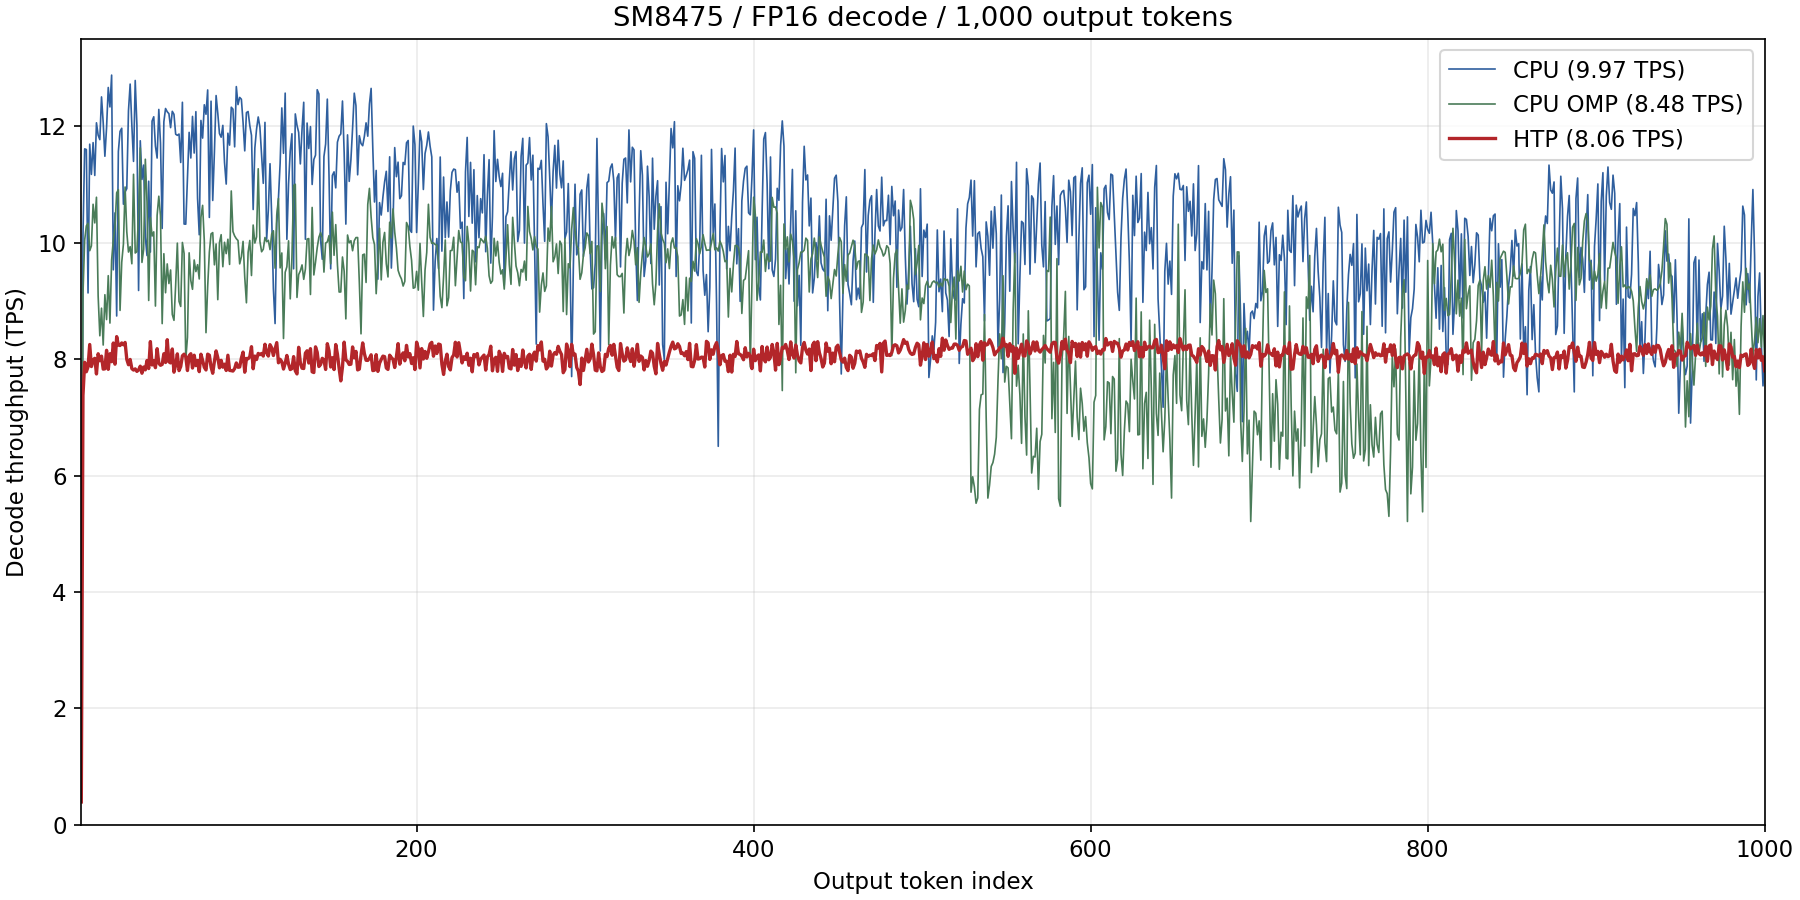
GGML_OPENMP=ON / OMP_NUM_THREADS=2 の比較用ビルドです。| 経路 | スループット |
|---|---|
| CPU | 9.971 tokens/s |
| CPU(OpenMP) | 8.482 tokens/s |
| NPU(QNN) | 8.062 tokens/s |
NPU の Decode は CPU の 0.81 倍です。
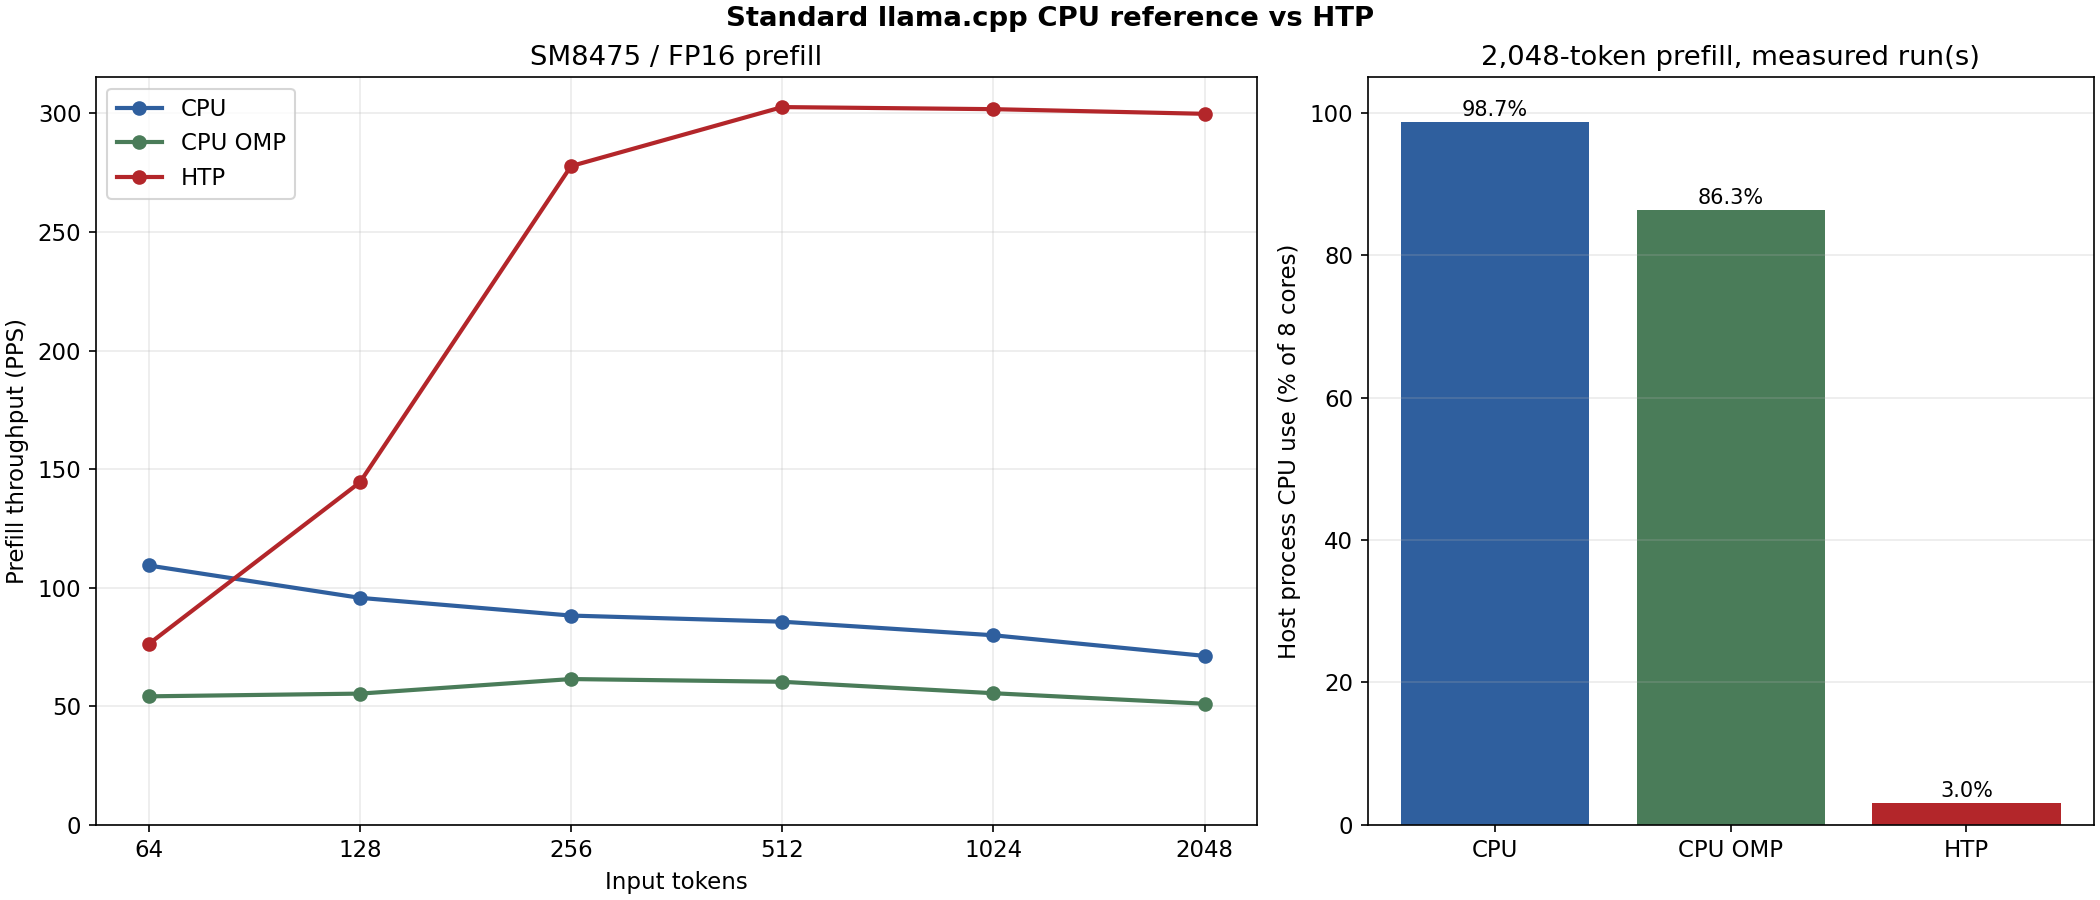
| 経路 | 64 | 128 | 256 | 512 | 1024 | 2048 |
|---|---|---|---|---|---|---|
| CPU | 109.359 | 95.722 | 88.243 | 85.663 | 79.940 | 71.244 |
| CPU(OpenMP) | 54.184 | 55.333 | 61.476 | 60.319 | 55.500 | 51.064 |
| NPU(FP16) | 76.244 | 144.406 | 277.775 | 302.667 | 301.791 | 299.827 |
2,048 トークン入力では、NPU が CPU より約 4.21 倍高速(OpenMP ビルド比 5.87 倍高速)です。
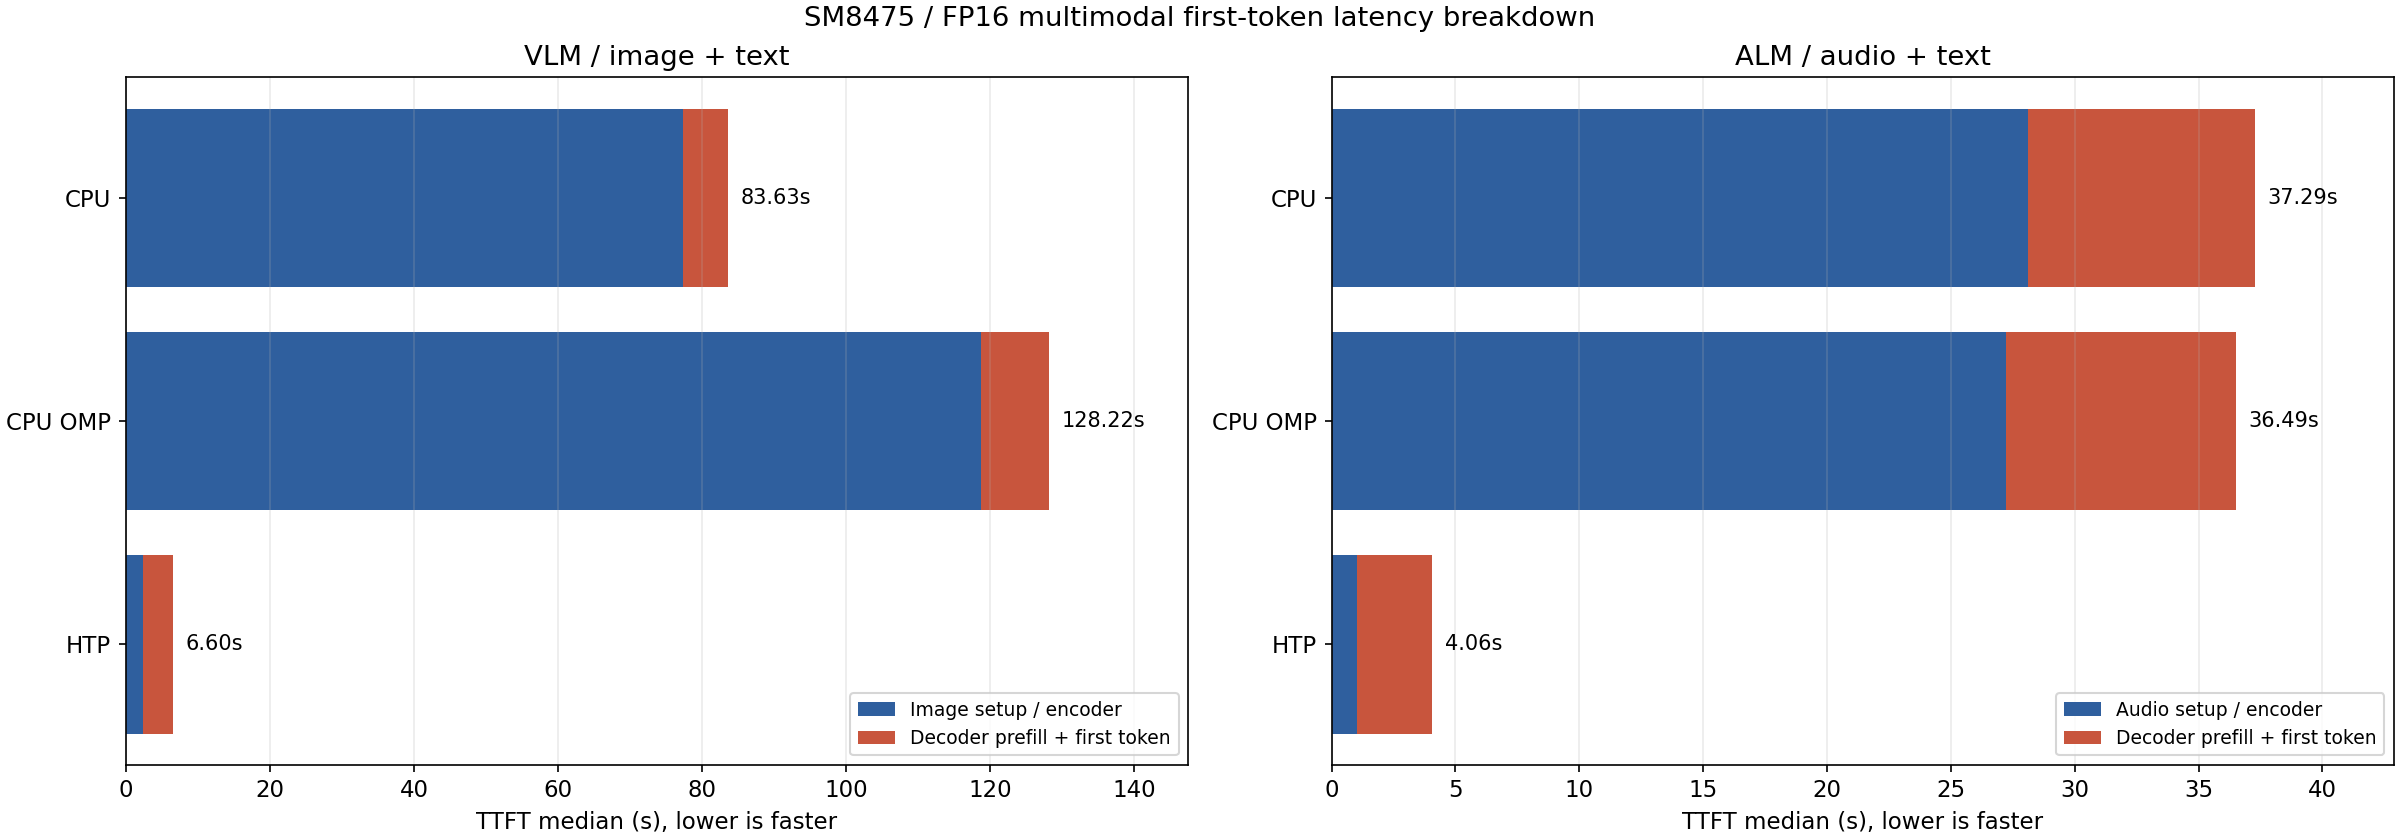
| 入力 | 経路 | TTFT(中央値) | Decode(中央値) | 出力トークン数 |
|---|---|---|---|---|
| 画像 | CPU | 83.63 秒 | 12.081 tokens/s | 100 |
| 画像 | CPU(OpenMP) | 128.22 秒 | 7.491 tokens/s | 100 |
| 画像 | NPU(FP16) | 6.60 秒 | 7.033 tokens/s | 100 |
| 音声 | CPU | 37.29 秒 | 10.416 tokens/s | 21〜89 |
| 音声 | CPU(OpenMP) | 36.49 秒 | 10.539 tokens/s | 21〜89 |
| 音声 | NPU(FP16) | 4.06 秒 | 6.495 tokens/s | 21〜90 |
NPU の TTFT は CPU より、画像入力で約 12.7 倍、音声入力で約 9.2 倍高速です。
| 経路 | CPU 使用率 |
|---|---|
| CPU | 98.7% |
| CPU(OpenMP) | 86.3% |
| NPU(QNN) | 3.0% |
| 経路 | スループット |
|---|---|
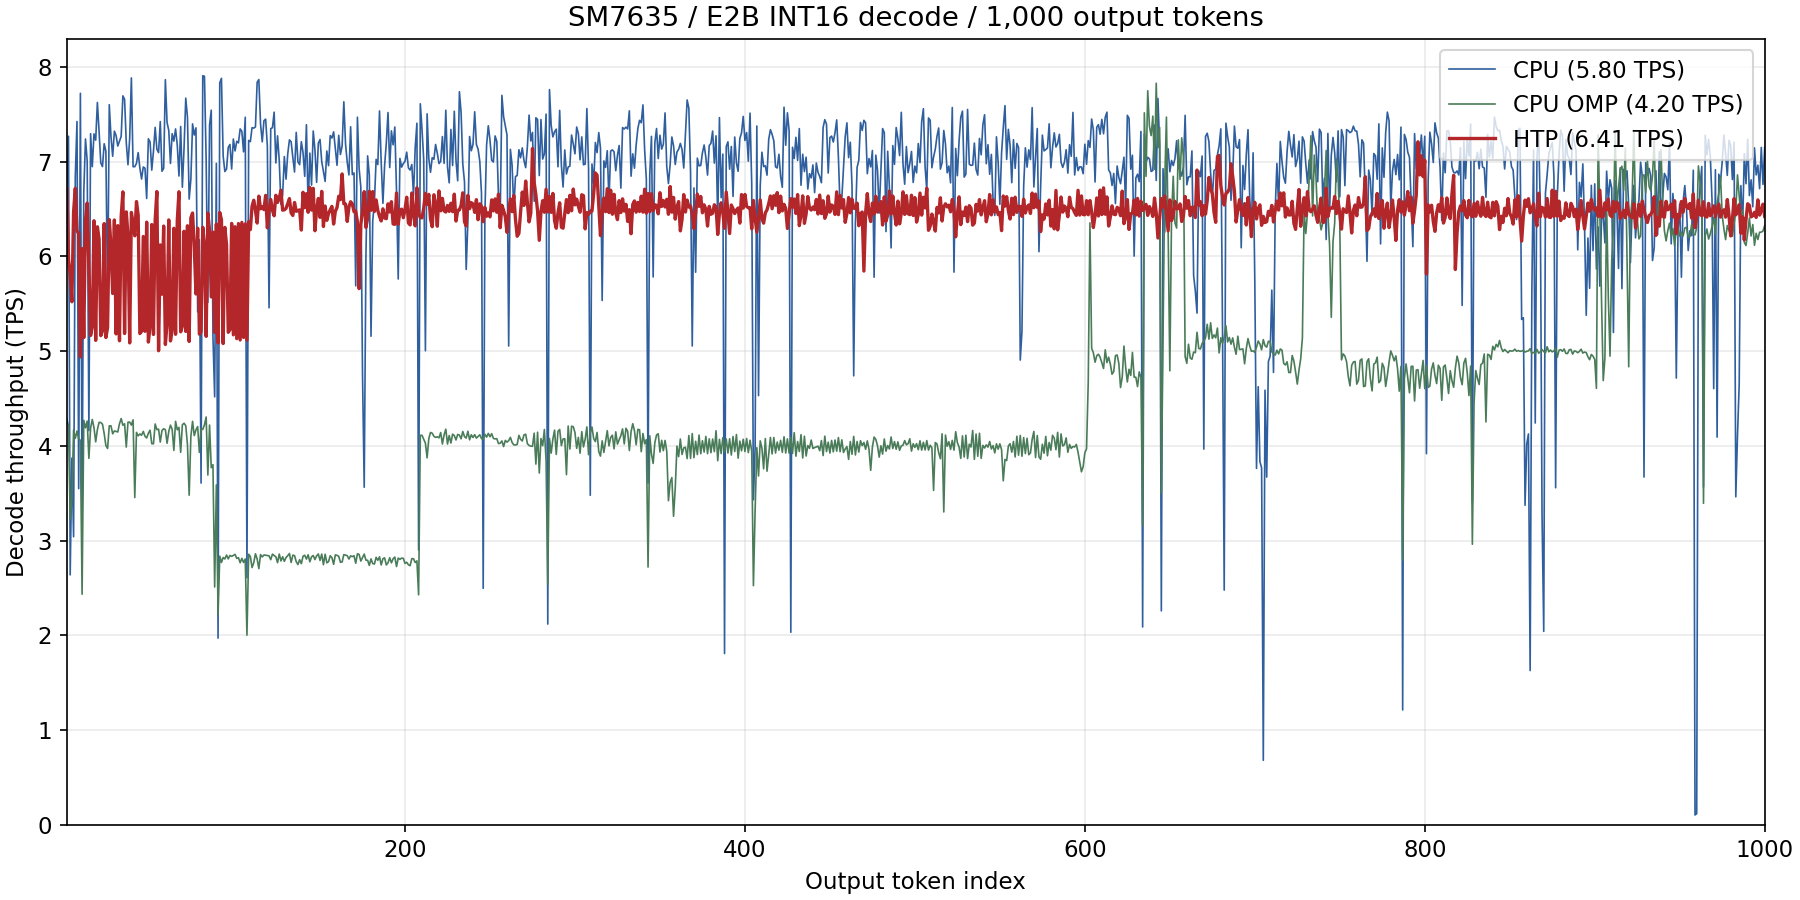
| CPU | 5.805 tokens/s |
| CPU(OpenMP) | 4.195 tokens/s |
| NPU(QNN) | 6.410 tokens/s |
NPU の Decode は CPU より 1.10 倍(OpenMP ビルド比では 1.53 倍)高速です。
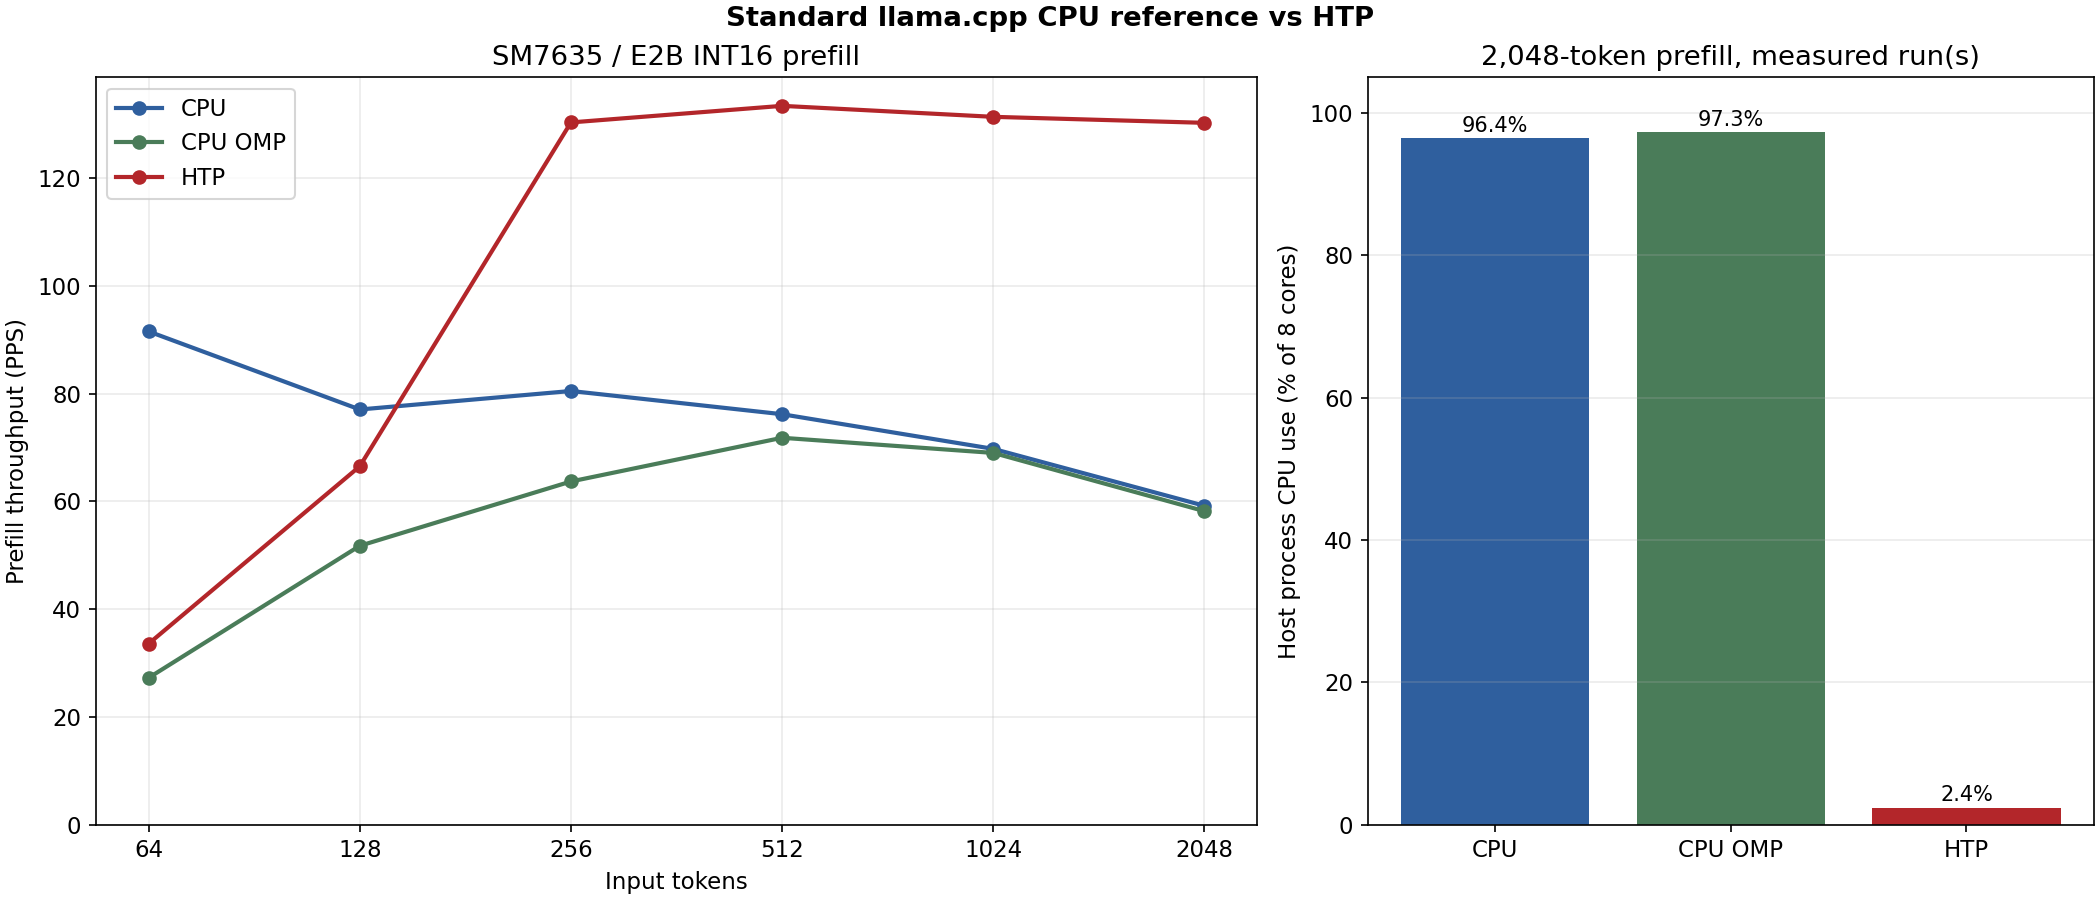
| 経路 | 64 | 128 | 256 | 512 | 1024 | 2048 |
|---|---|---|---|---|---|---|
| CPU | 91.550 | 77.064 | 80.496 | 76.187 | 69.757 | 59.192 |
| CPU(OpenMP) | 27.441 | 49.999 | 62.793 | 70.965 | 69.228 | 56.059 |
| NPU(Int16) | 33.601 | 66.523 | 130.329 | 133.404 | 131.367 | 130.252 |
2,048 トークン入力では、NPU が CPU より約 2.20 倍高速(OpenMP ビルド比 2.32 倍高速)です。
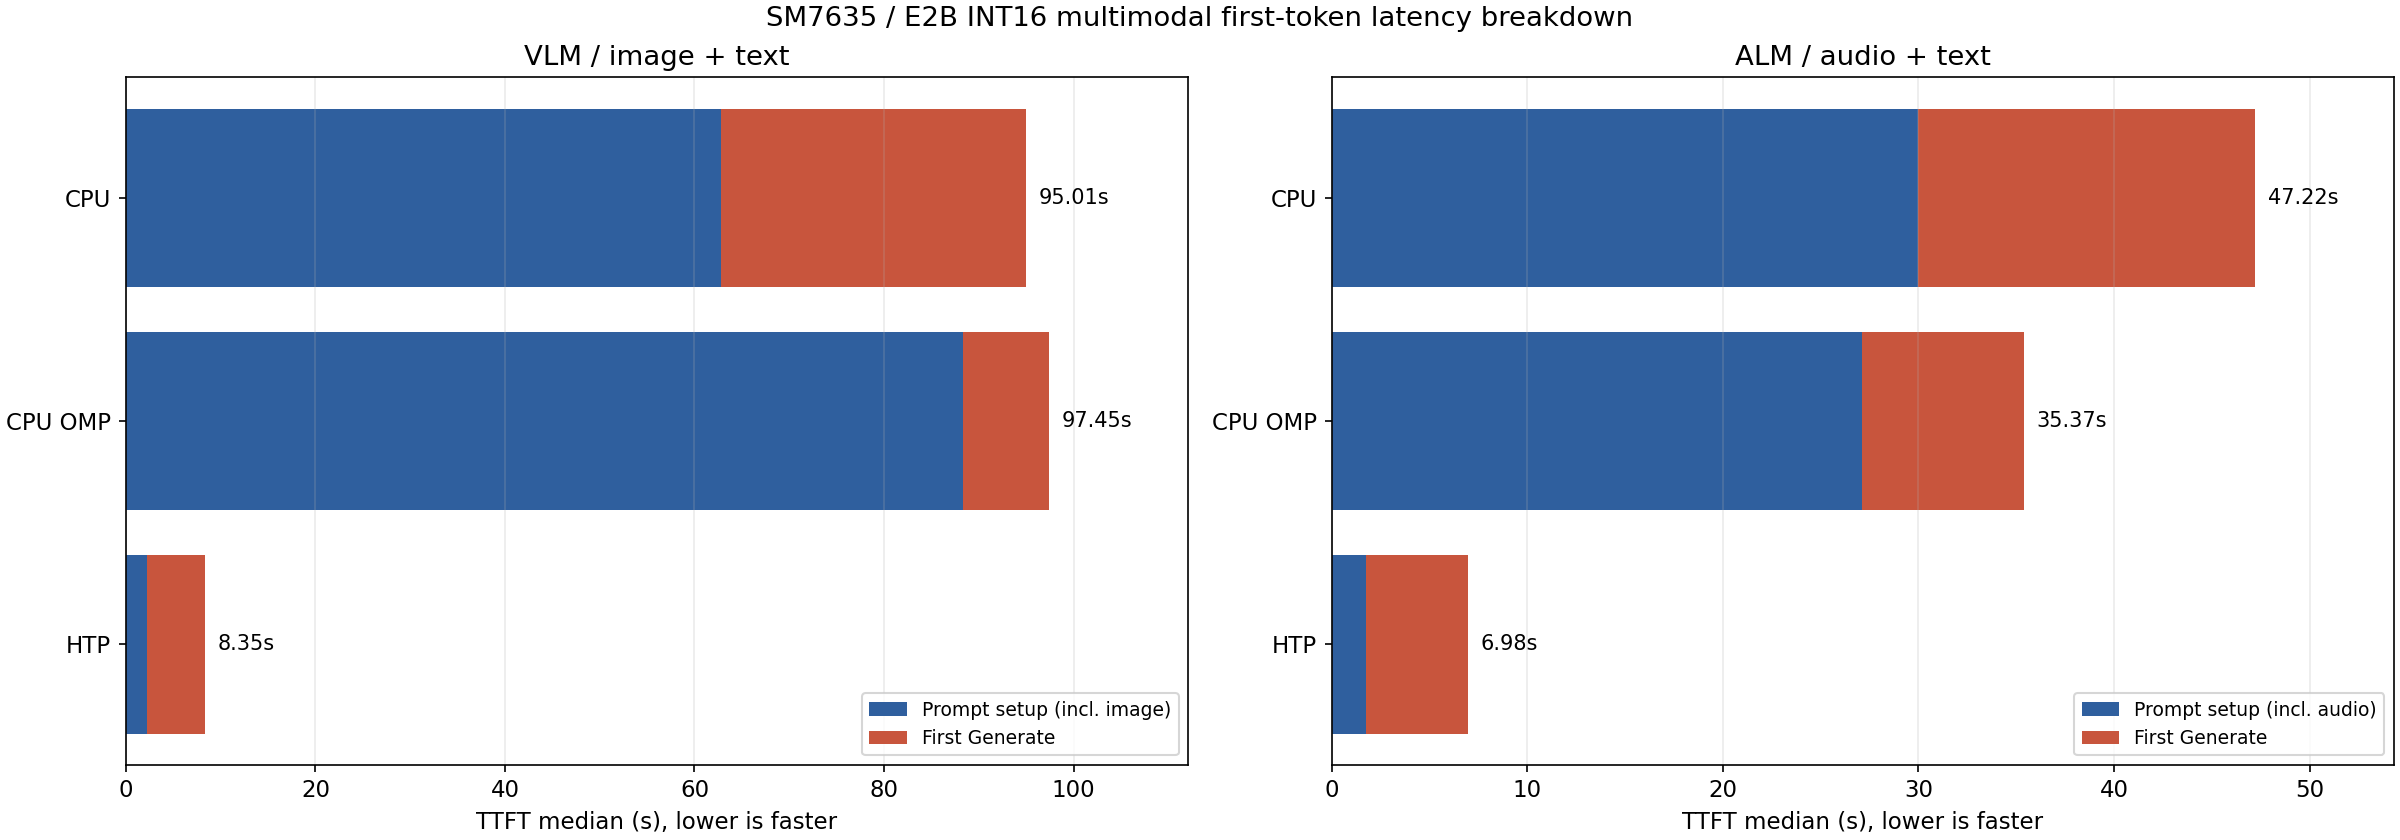
| 入力 | 経路 | TTFT(中央値) | Decode(中央値) | 出力トークン数 |
|---|---|---|---|---|
| 画像 | CPU | 95.01 秒 | 5.891 tokens/s | 100 |
| 画像 | CPU(OpenMP) | 97.45 秒 | 3.569 tokens/s | 100 |
| 画像 | NPU(Int16) | 8.35 秒 | 6.444 tokens/s | 100 |
| 音声 | CPU | 47.22 秒 | 5.166 tokens/s | 21〜89 |
| 音声 | CPU(OpenMP) | 35.37 秒 | 3.846 tokens/s | 21〜89 |
| 音声 | NPU(Int16) | 6.98 秒 | 6.356 tokens/s | 22〜60 |
NPU の TTFT は CPU より、画像入力で約 11.4 倍、音声入力で約 6.8 倍高速です。
| 経路 | CPU 使用率 |
|---|---|
| CPU | 96.4% |
| CPU(OpenMP) | 97.3% |
| NPU(QNN) | 2.4% |
LLM / VLM / ALM の各構成を 8 トークン生成で実行したときのメモリ使用量です(単位 MiB、コンテキスト長 8192)。CPU は Q4_0 GGUF と BF16 の mmproj、NPU は Int16 の QNN Model を使用しています。モデルは mmap で読み込むため、実際に確保した作業メモリである匿名メモリ(RssAnon)と、ページキャッシュとして再利用できるファイルマッピング(RssFile)を分けて記載します。ピークはプロセスの最大常駐サイズ(VmHWM)です。
| ワークロード | 実行系 | VmHWM | RssAnon | RssFile |
|---|---|---|---|---|
| LLM | CPU | 4574.2 | 1524.1 | 2896.5 |
| LLM | NPU(Int16) | 1666.8 | 386.4 | 1276.2 |
| VLM | CPU | 4881.2 | 2512.4 | 40.3 |
| VLM | NPU(Int16) | 2161.2 | 673.3 | 1483.7 |
| ALM | CPU | 4873.7 | 2623.0 | 1509.1 |
| ALM | NPU(Int16) | 2202.5 | 591.6 | 1606.7 |
mallopt(M_PURGE, 0) を呼ぶと 23 MiB 前後になります。| 経路 | スループット |
|---|---|
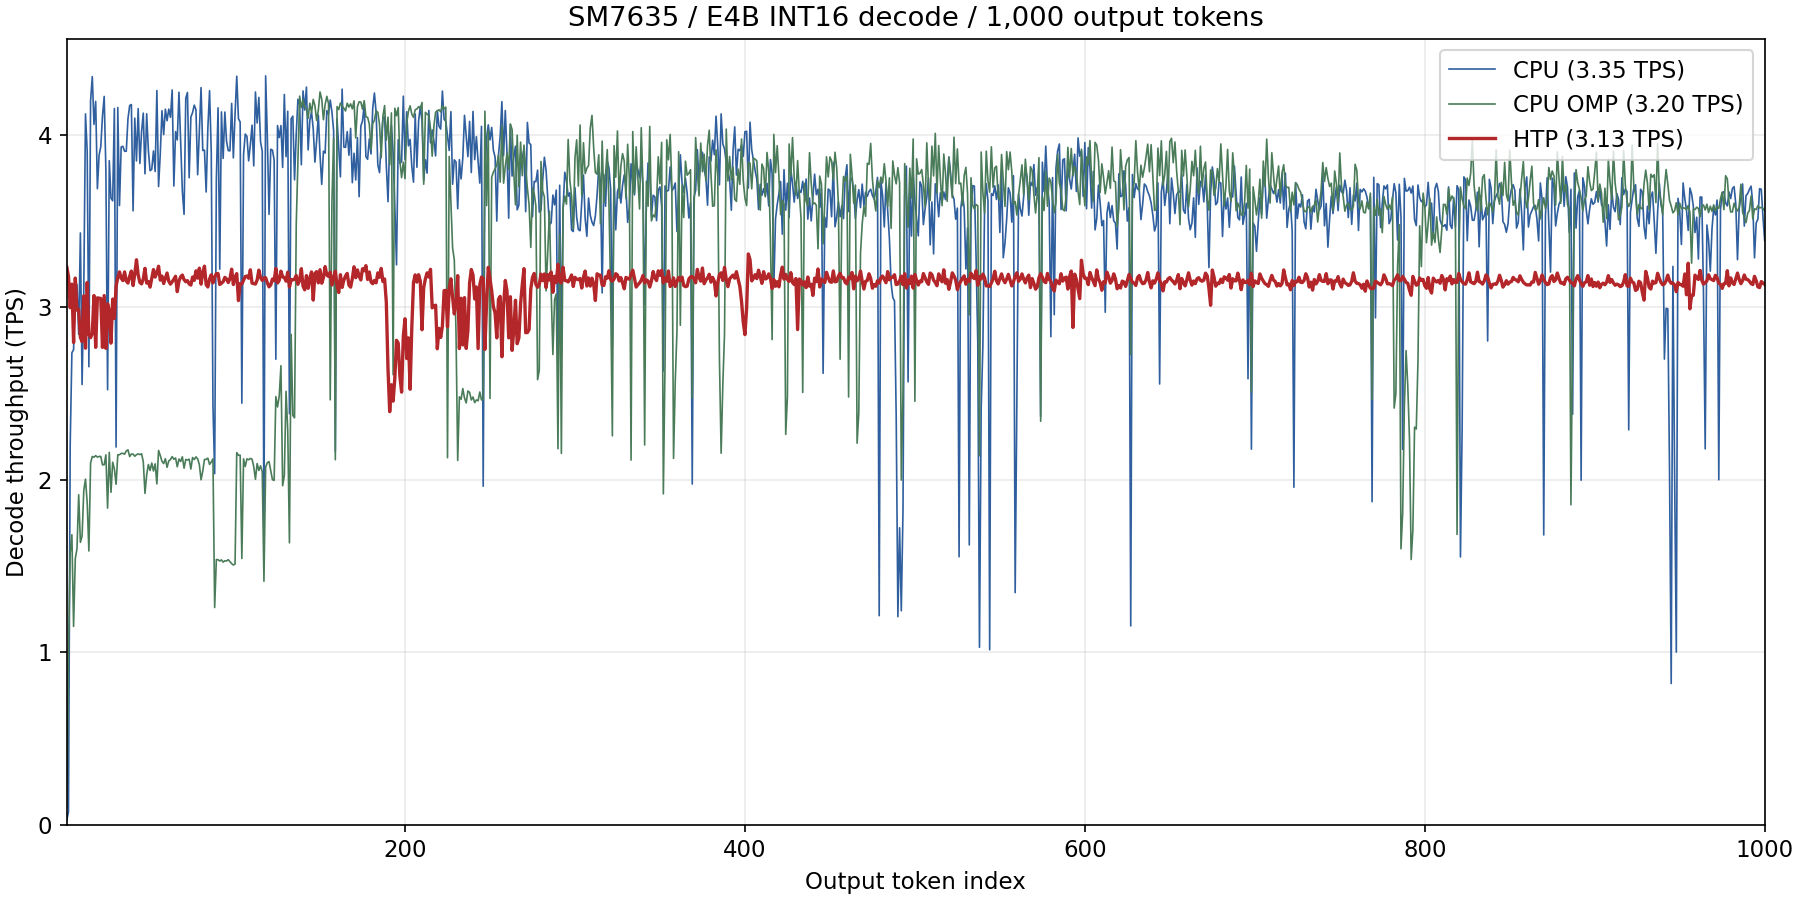
| CPU | 3.351 tokens/s |
| CPU(OpenMP) | 3.203 tokens/s |
| NPU(QNN) | 3.128 tokens/s |
NPU の Decode は CPU の 0.93 倍です。
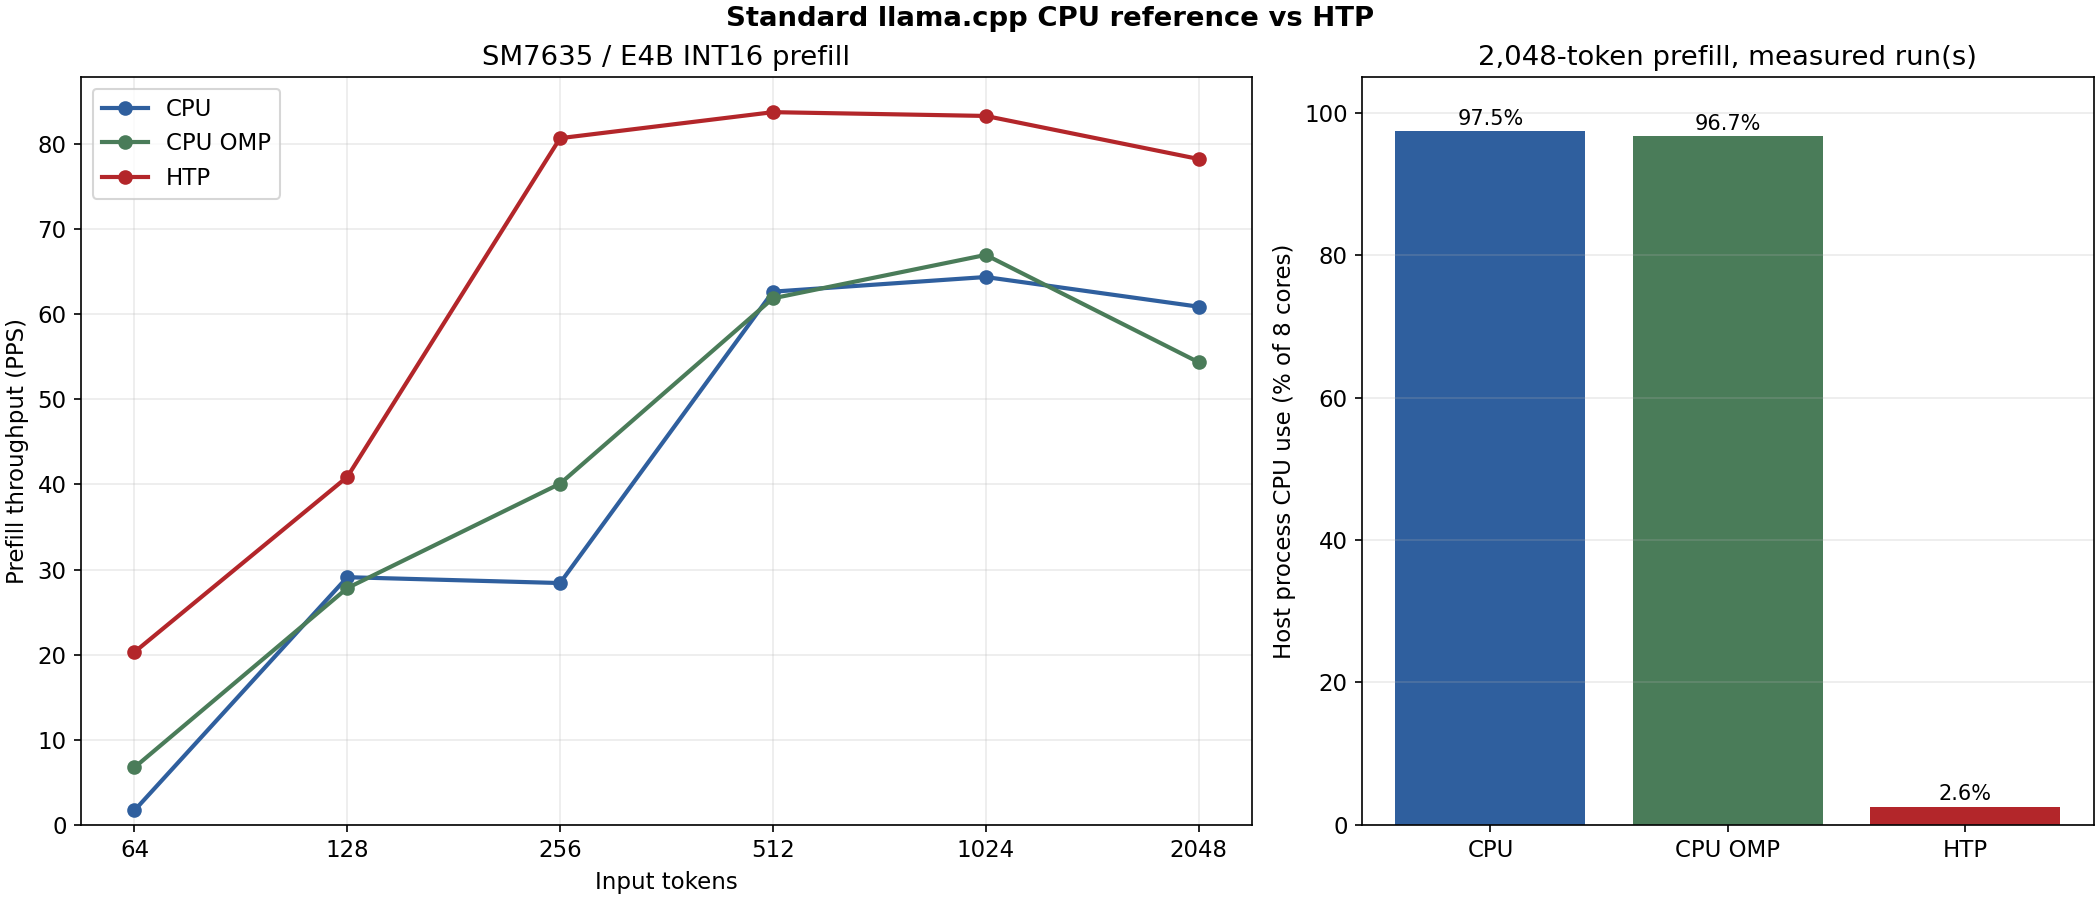
| 経路 | 64 | 128 | 256 | 512 | 1024 | 2048 |
|---|---|---|---|---|---|---|
| CPU | 1.697 | 29.105 | 28.417 | 62.663 | 64.383 | 60.897 |
| CPU(OpenMP) | 6.746 | 27.824 | 40.097 | 61.877 | 66.980 | 54.372 |
| NPU(Int16) | 20.304 | 40.890 | 80.700 | 83.758 | 83.314 | 78.258 |
2,048 トークン入力では、NPU が CPU より約 1.29 倍高速(OpenMP ビルド比 1.44 倍高速)です。
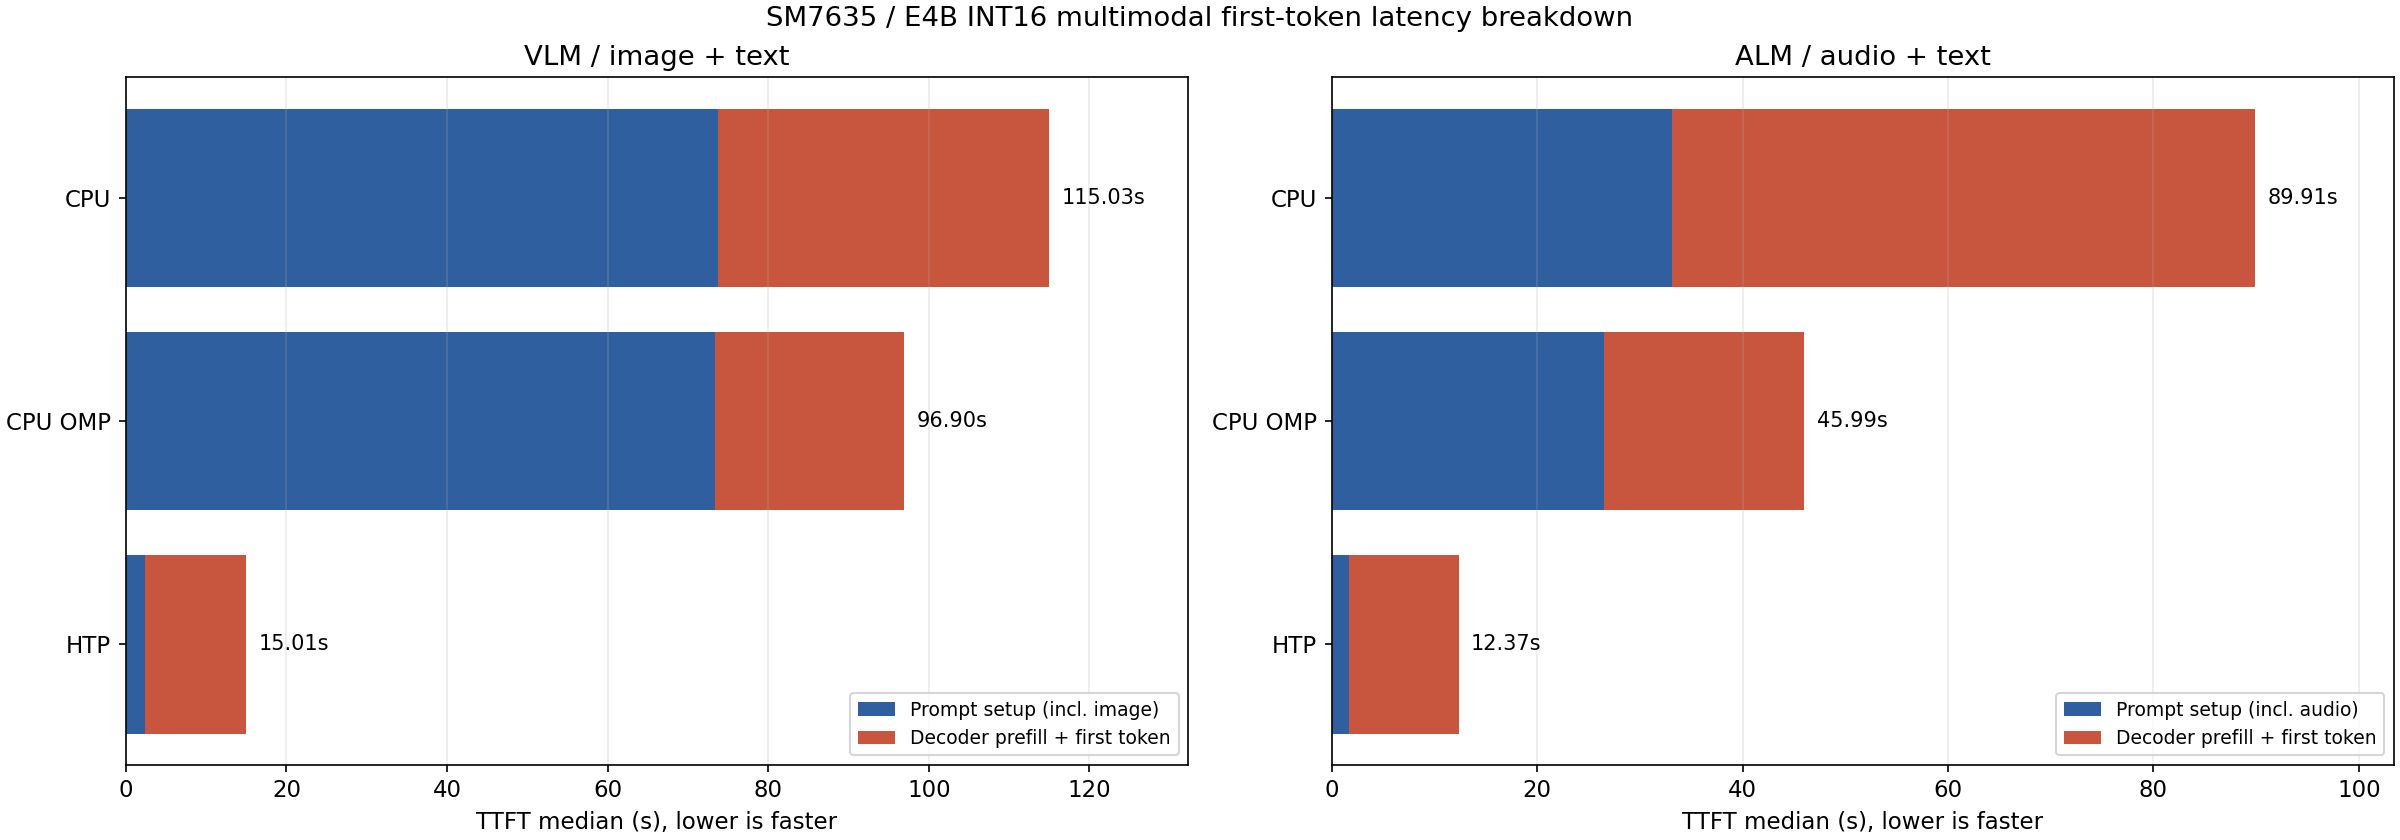
| 入力 | 経路 | TTFT(中央値) | Decode(中央値) | 出力トークン数 |
|---|---|---|---|---|
| 画像 | CPU | 115.03 秒 | 3.332 tokens/s | 100 |
| 画像 | CPU(OpenMP) | 96.90 秒 | 2.642 tokens/s | 100 |
| 画像 | NPU(Int16) | 15.01 秒 | 3.098 tokens/s | 100 |
| 音声 | CPU | 89.91 秒 | 3.053 tokens/s | 21〜91 |
| 音声 | CPU(OpenMP) | 45.99 秒 | 2.947 tokens/s | 21〜91 |
| 音声 | NPU(Int16) | 12.37 秒 | 3.018 tokens/s | 21〜91 |
NPU の TTFT は CPU より、画像入力で約 7.7 倍、音声入力で約 7.3 倍高速です。
| 経路 | CPU 使用率 |
|---|---|
| CPU | 97.5% |
| CPU(OpenMP) | 96.7% |
| NPU(QNN) | 2.6% |
81 トークン入力・100 トークン出力の LLM を 1 回ずつ実行した参考測定です(単位 MiB)。RssAnon と RssFile の内訳は取得しておらず、実行中の PSS を併記します。E2B の表とは条件が異なります。
| ワークロード | 実行系 | VmHWM | 実行中の PSS |
|---|---|---|---|
| LLM | CPU | 5569.8 | 4432.7 |
| LLM | CPU(OpenMP) | 5518.2 | 3922.2 |
| LLM | NPU(Int16) | 1976.0 | 1801.8 |
E4B でも NPU のピークは CPU の約 3 分の 1 です。この測定は端末が Thermal Status 1 の状態で、Android のページ回収の影響を受けています。
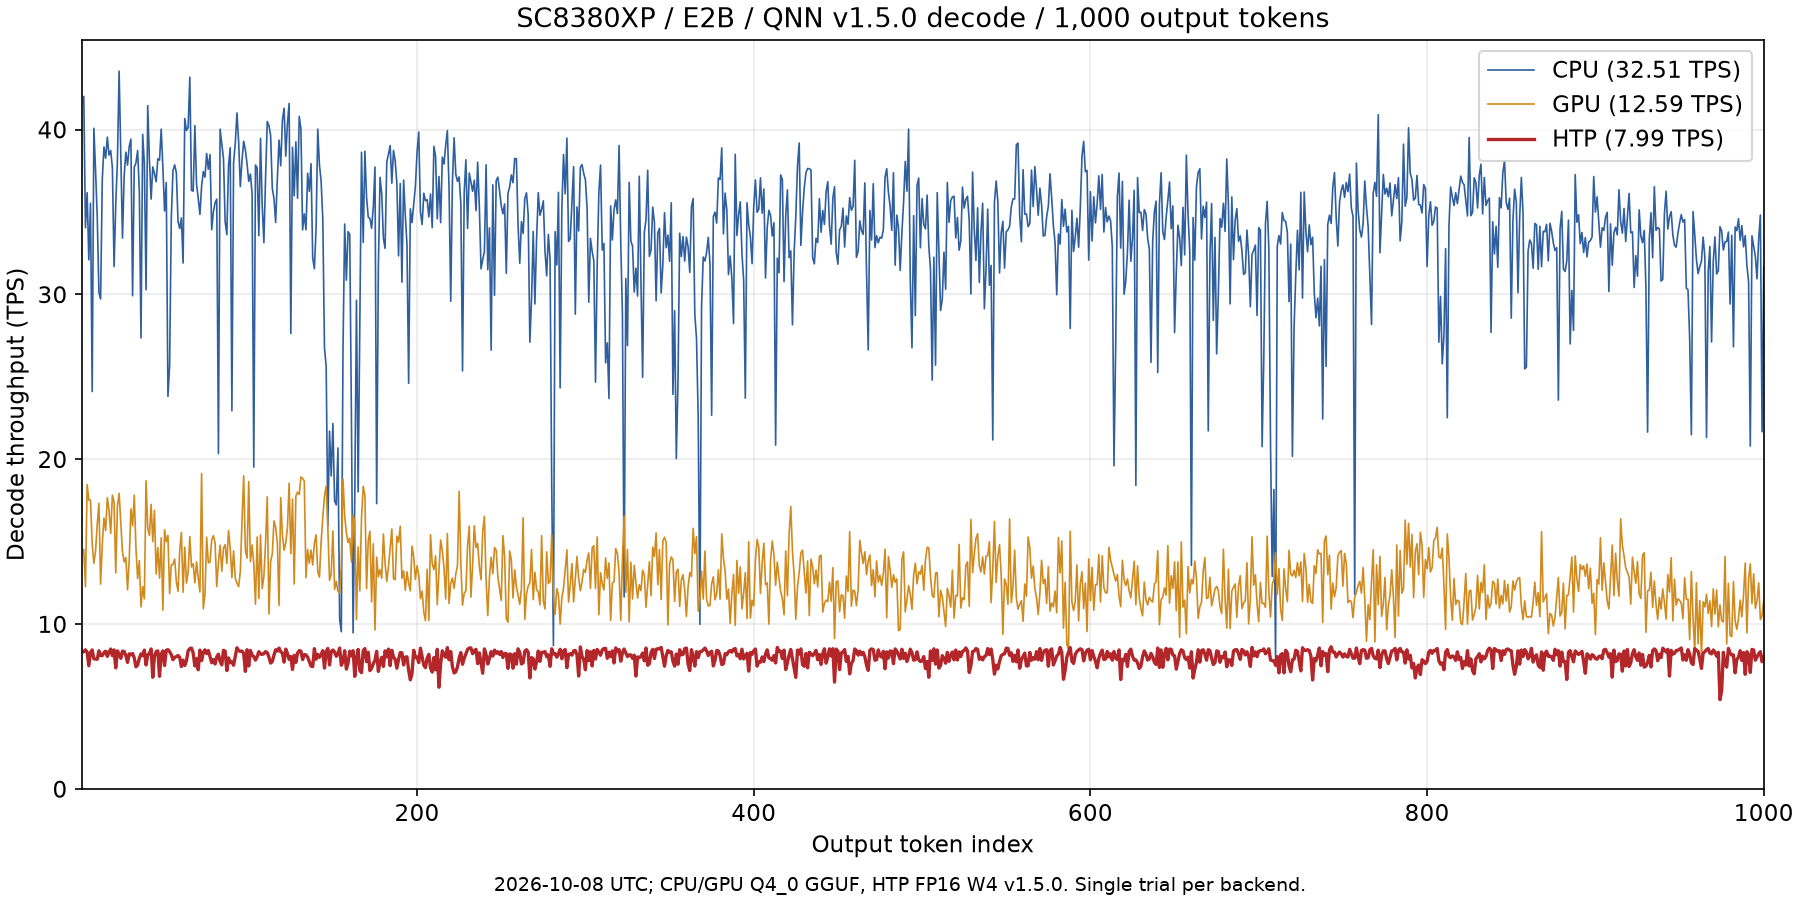
| 経路 | スループット |
|---|---|
| CPU | 32.505 tokens/s |
| GPU | 12.590 tokens/s |
| NPU(QNN) | 7.988 tokens/s |
NPU の Decode は CPU の 0.25 倍です。
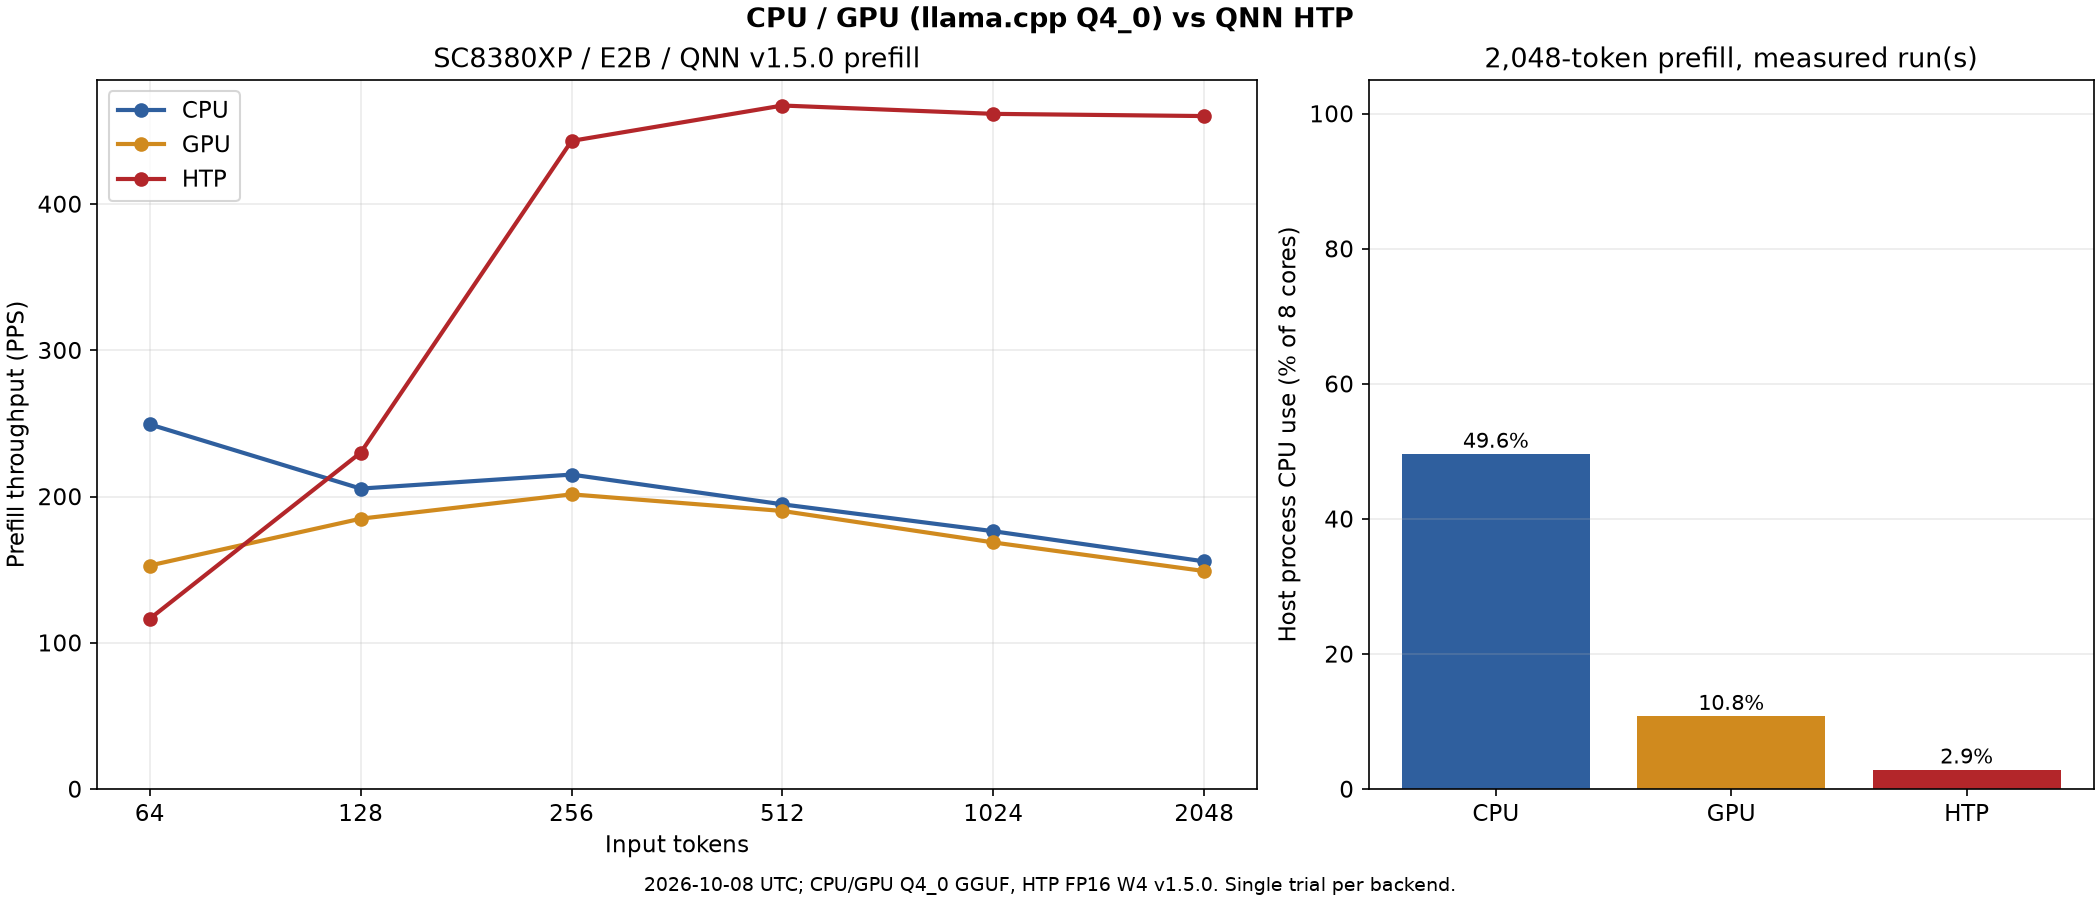
| 経路 | 64 | 128 | 256 | 512 | 1024 | 2048 |
|---|---|---|---|---|---|---|
| CPU | 249.314 | 205.403 | 214.986 | 194.638 | 176.262 | 155.627 |
| GPU | 152.814 | 184.829 | 201.471 | 190.109 | 168.583 | 149.012 |
| NPU(FP16) | 116.418 | 229.981 | 443.136 | 467.341 | 461.637 | 460.136 |
2,048 トークン入力では、NPU が CPU より約 2.96 倍高速です。
| 入力 | 経路 | TTFT | Decode | 出力トークン数 |
|---|---|---|---|---|
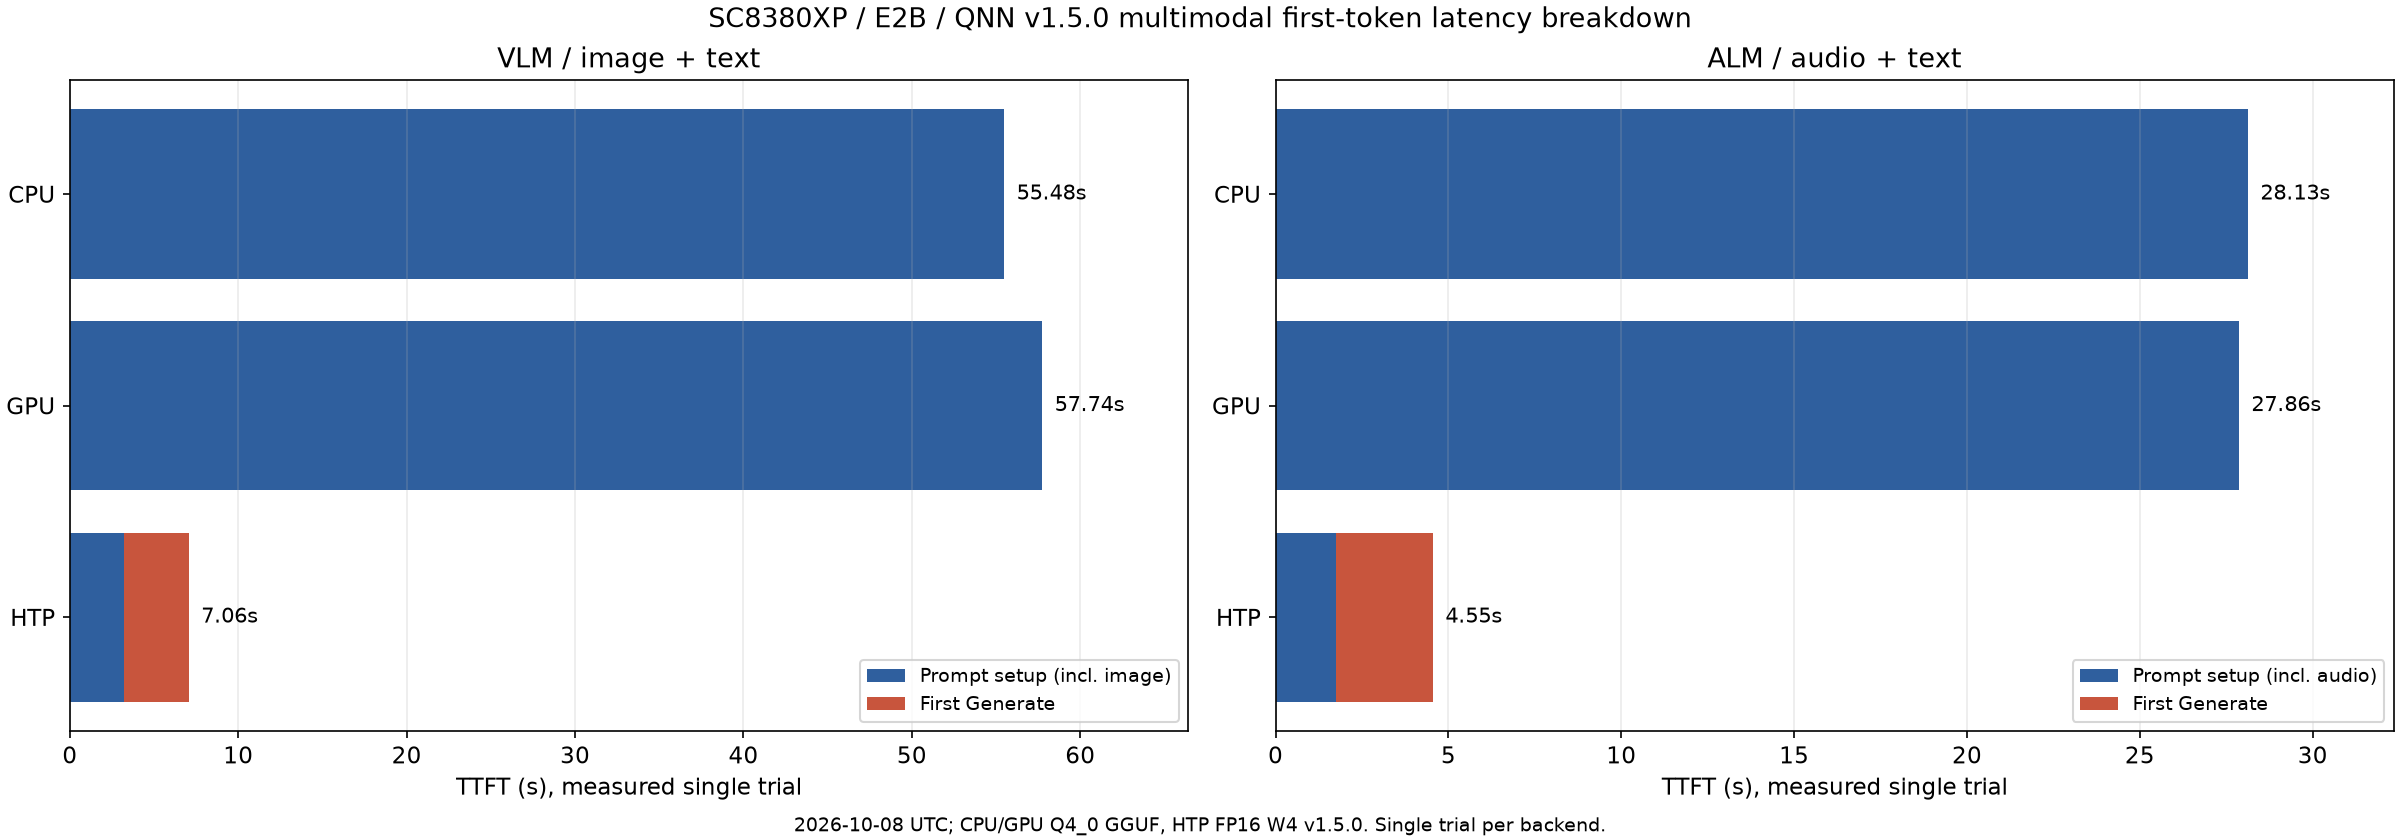
| 画像 | CPU | 55.48 秒 | 37.546 tokens/s | 100 |
| 画像 | GPU | 57.74 秒 | 12.770 tokens/s | 100 |
| 画像 | NPU(FP16) | 7.06 秒 | 7.961 tokens/s | 100 |
| 音声 | CPU | 28.13 秒 | 37.924 tokens/s | 33 |
| 音声 | GPU | 27.86 秒 | 13.064 tokens/s | 33 |
| 音声 | NPU(FP16) | 4.55 秒 | 8.162 tokens/s | 33 |
NPU の TTFT は CPU より、画像入力で約 7.9 倍、音声入力で約 6.2 倍高速です。
| 経路 | CPU 使用率 |
|---|---|
| CPU | 49.6% |
| GPU | 10.8% |
| NPU(QNN) | 2.9% |
CPU は高性能コアの 4 コアで実行しているため、CPU の使用率は 50% 前後です。
| 経路 | スループット |
|---|---|
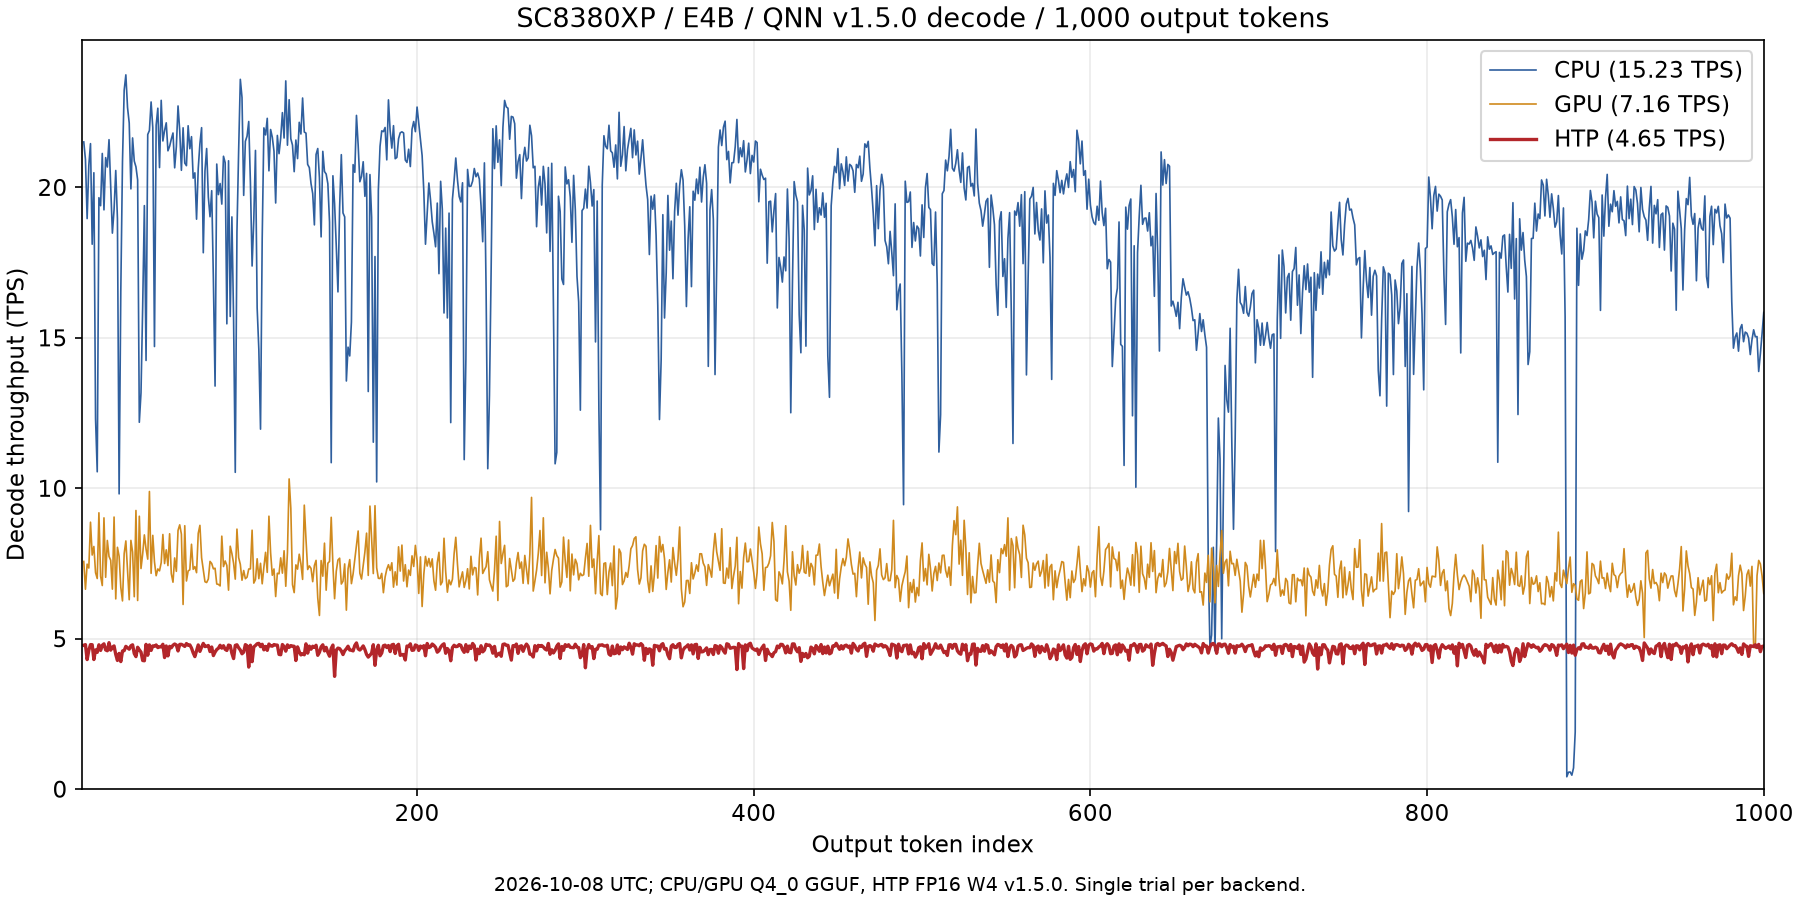
| CPU | 15.230 tokens/s |
| GPU | 7.161 tokens/s |
| NPU(QNN) | 4.651 tokens/s |
NPU の Decode は CPU の 0.31 倍です。
| 経路 | 64 | 128 | 256 | 512 | 1024 | 2048 |
|---|---|---|---|---|---|---|
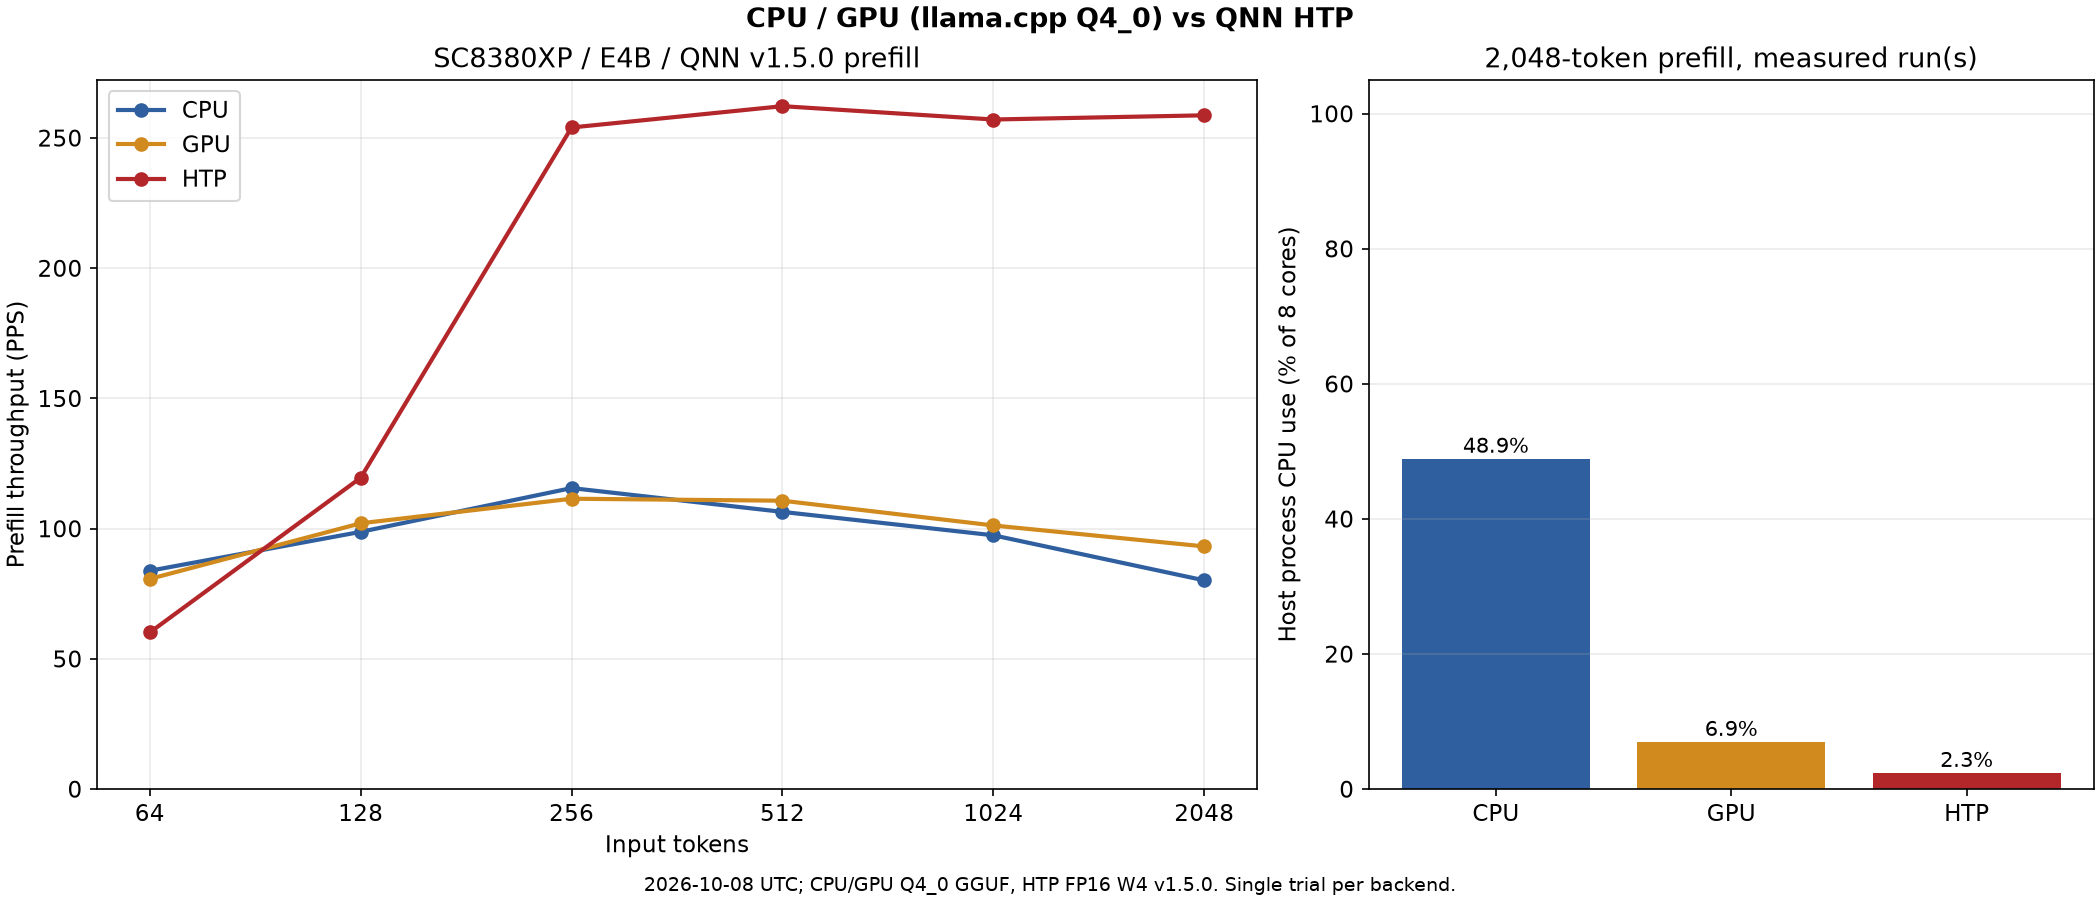
| CPU | 83.793 | 98.738 | 115.542 | 106.402 | 97.419 | 80.109 |
| GPU | 80.661 | 102.021 | 111.457 | 110.693 | 101.195 | 93.148 |
| NPU(FP16) | 60.101 | 119.511 | 254.001 | 262.182 | 257.062 | 258.672 |
2,048 トークン入力では、NPU が CPU より約 3.23 倍高速です。
| 入力 | 経路 | TTFT | Decode | 出力トークン数 |
|---|---|---|---|---|
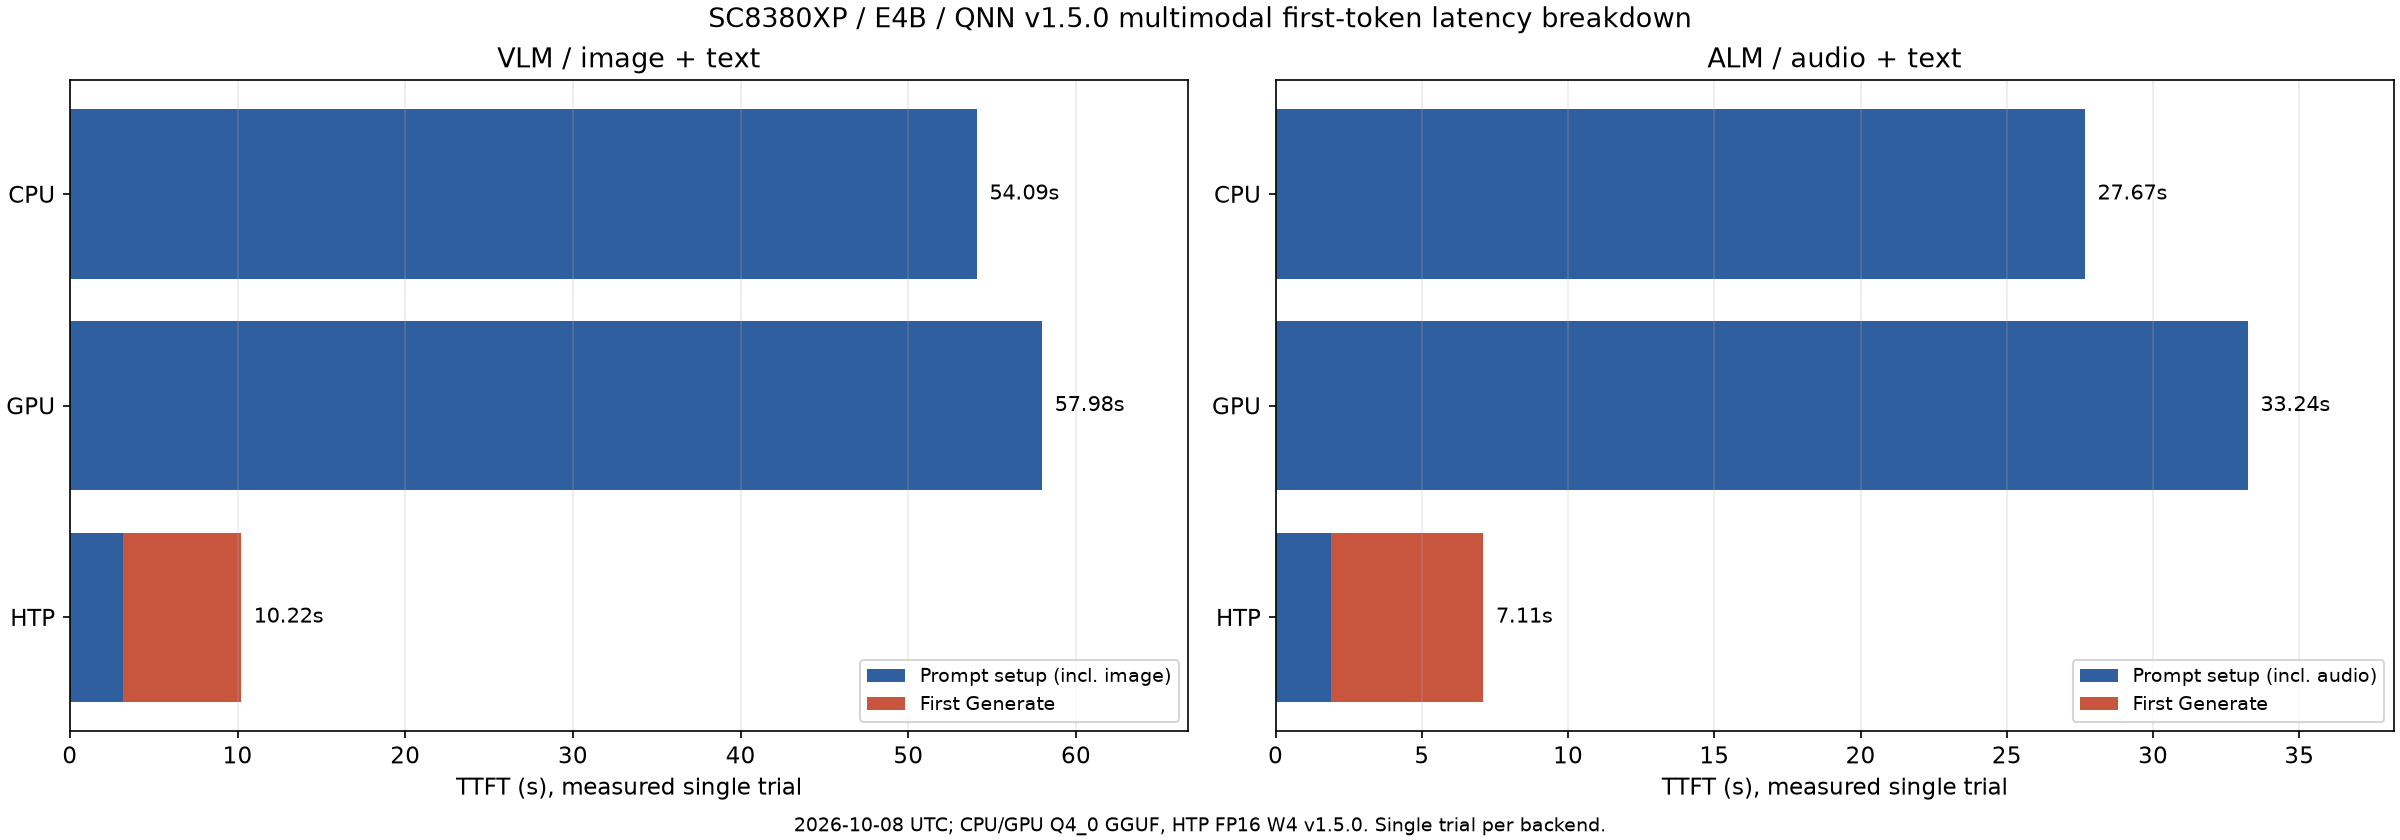
| 画像 | CPU | 54.09 秒 | 20.161 tokens/s | 100 |
| 画像 | GPU | 57.98 秒 | 7.230 tokens/s | 100 |
| 画像 | NPU(FP16) | 10.22 秒 | 4.644 tokens/s | 100 |
| 音声 | CPU | 27.67 秒 | 19.444 tokens/s | 33 |
| 音声 | GPU | 33.24 秒 | 7.094 tokens/s | 33 |
| 音声 | NPU(FP16) | 7.11 秒 | 4.606 tokens/s | 33 |
NPU の TTFT は CPU より、画像入力で約 5.3 倍、音声入力で約 3.9 倍高速です。
| 経路 | CPU 使用率 |
|---|---|
| CPU | 48.9% |
| GPU | 6.9% |
| NPU(QNN) | 2.3% |
CPU は高性能コアの 4 コアで実行しているため、CPU の使用率は 50% 前後です。
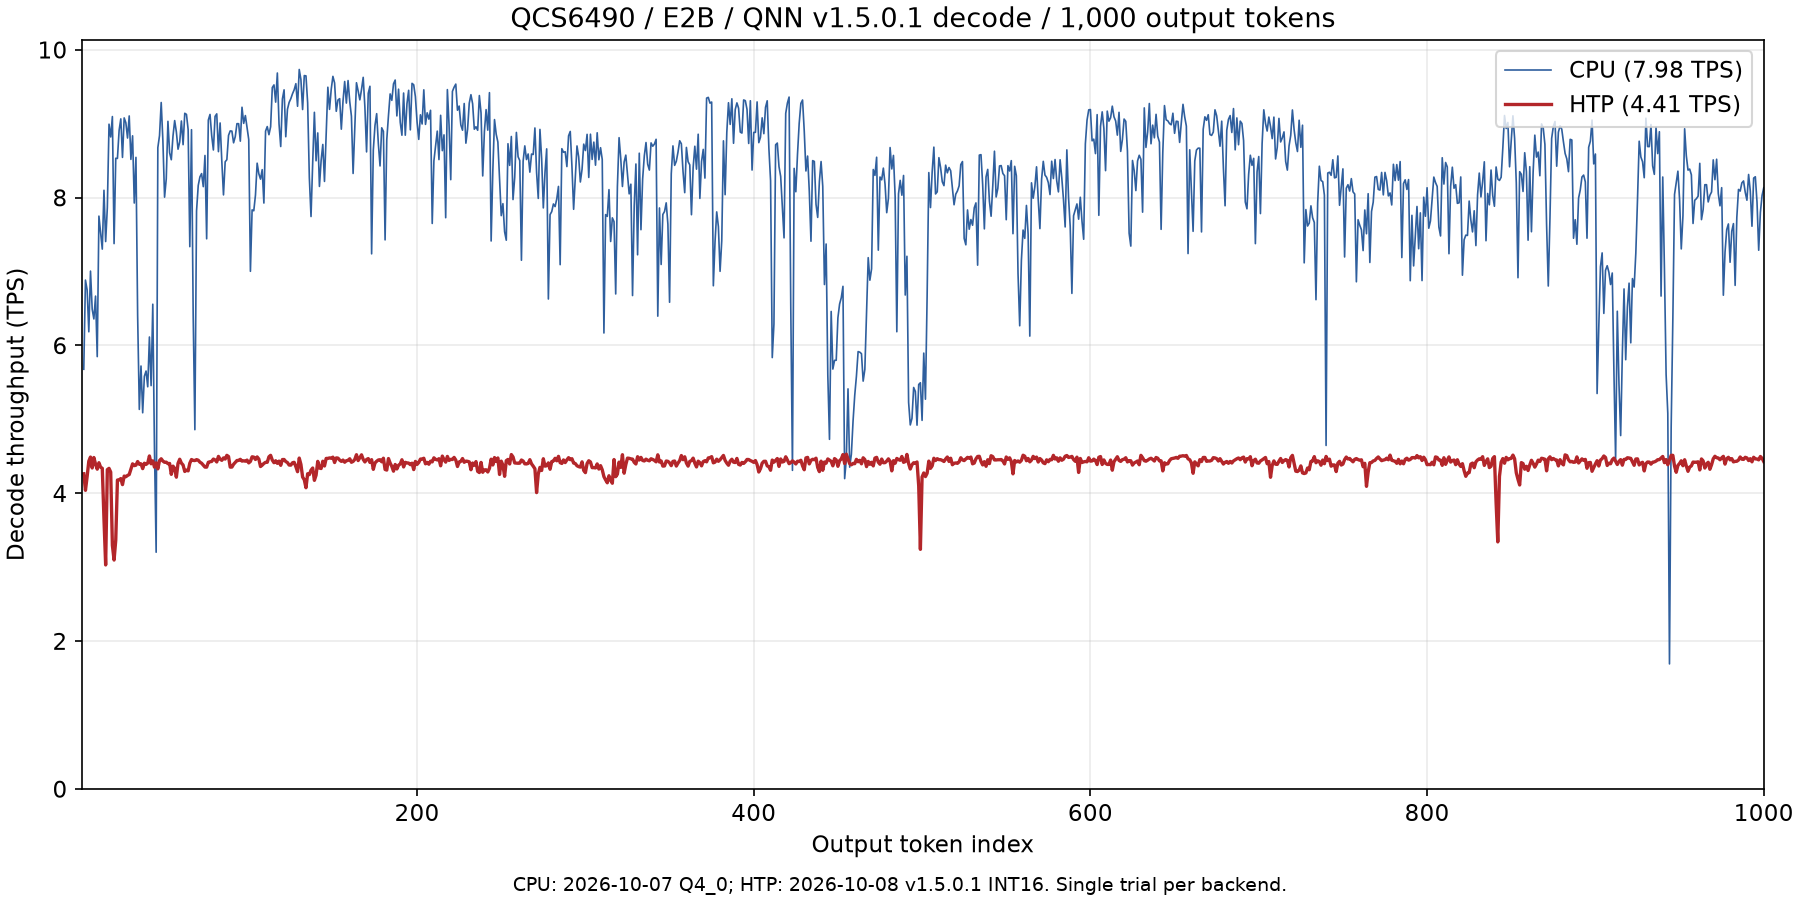
| 経路 | スループット |
|---|---|
| CPU | 7.983 tokens/s |
| NPU(QNN) | 4.405 tokens/s |
NPU の Decode は CPU の 0.55 倍です。
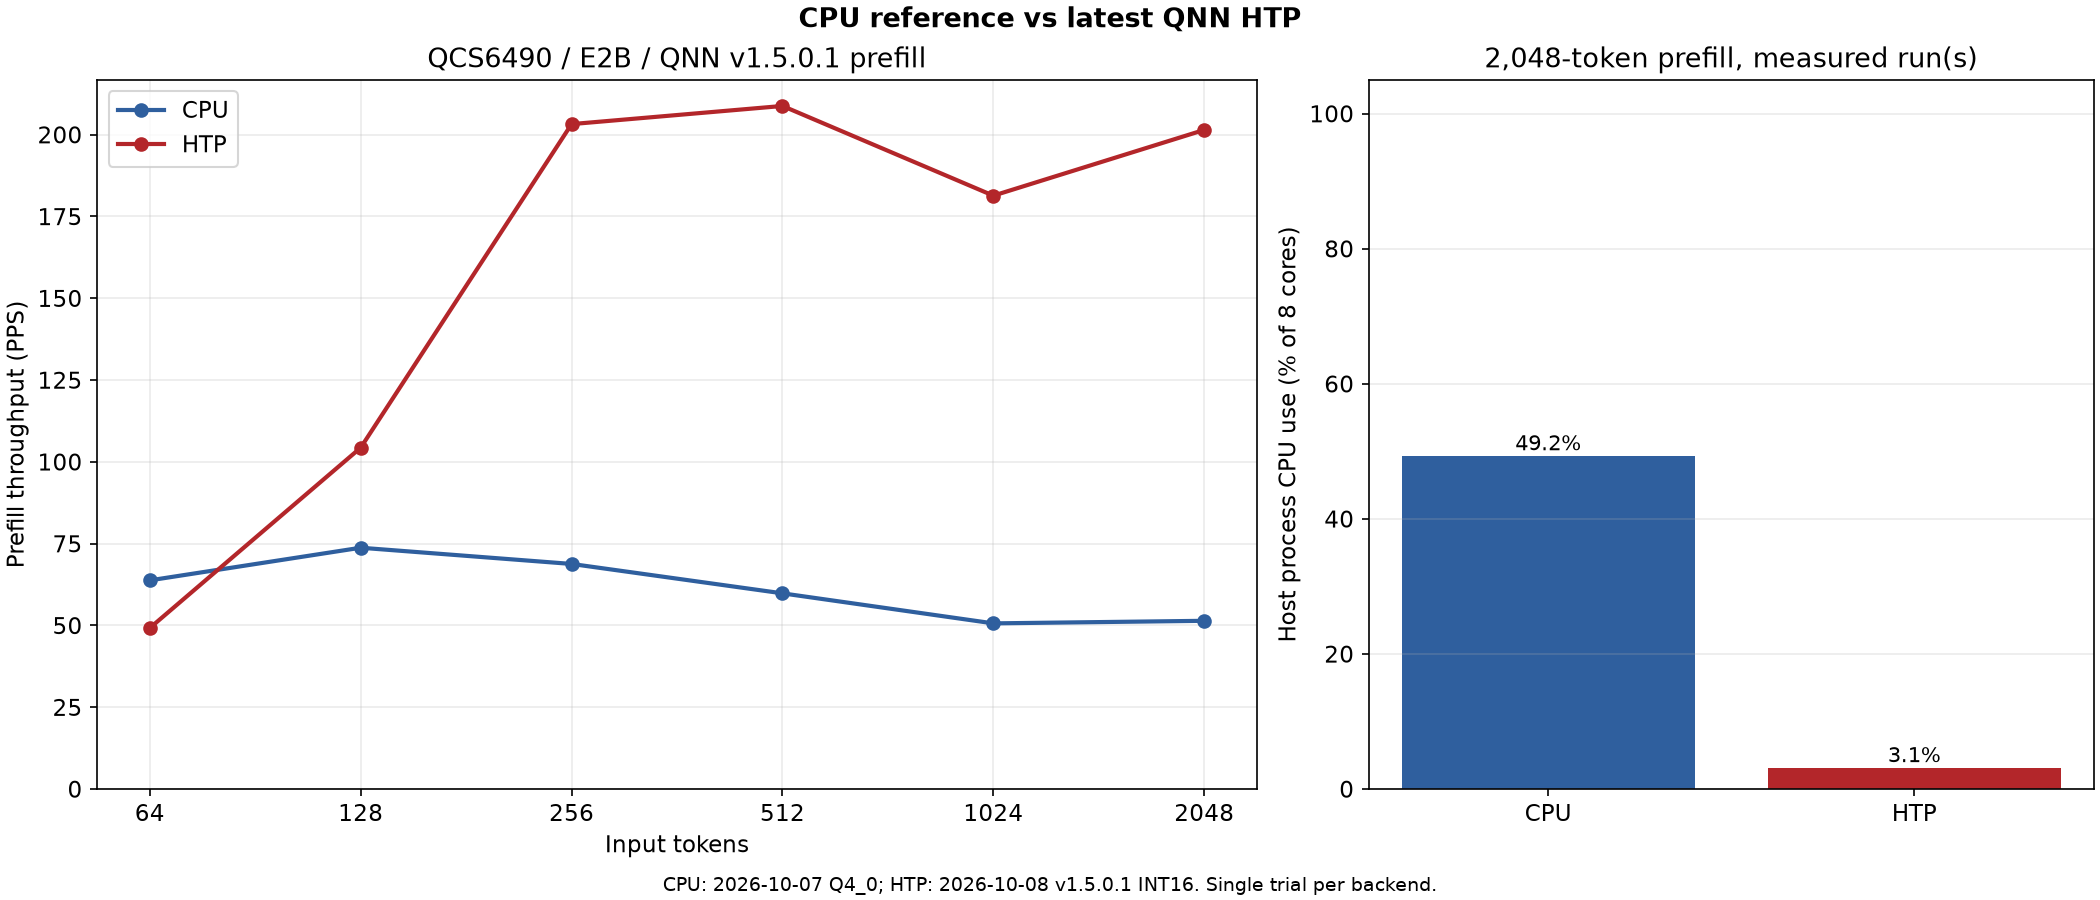
| 経路 | 64 | 128 | 256 | 512 | 1024 | 2048 |
|---|---|---|---|---|---|---|
| CPU | 63.773 | 73.745 | 68.787 | 59.803 | 50.623 | 51.408 |
| NPU(Int16) | 49.211 | 104.323 | 203.224 | 208.770 | 181.354 | 201.447 |
2,048 トークン入力では、NPU が CPU より約 3.92 倍高速です。
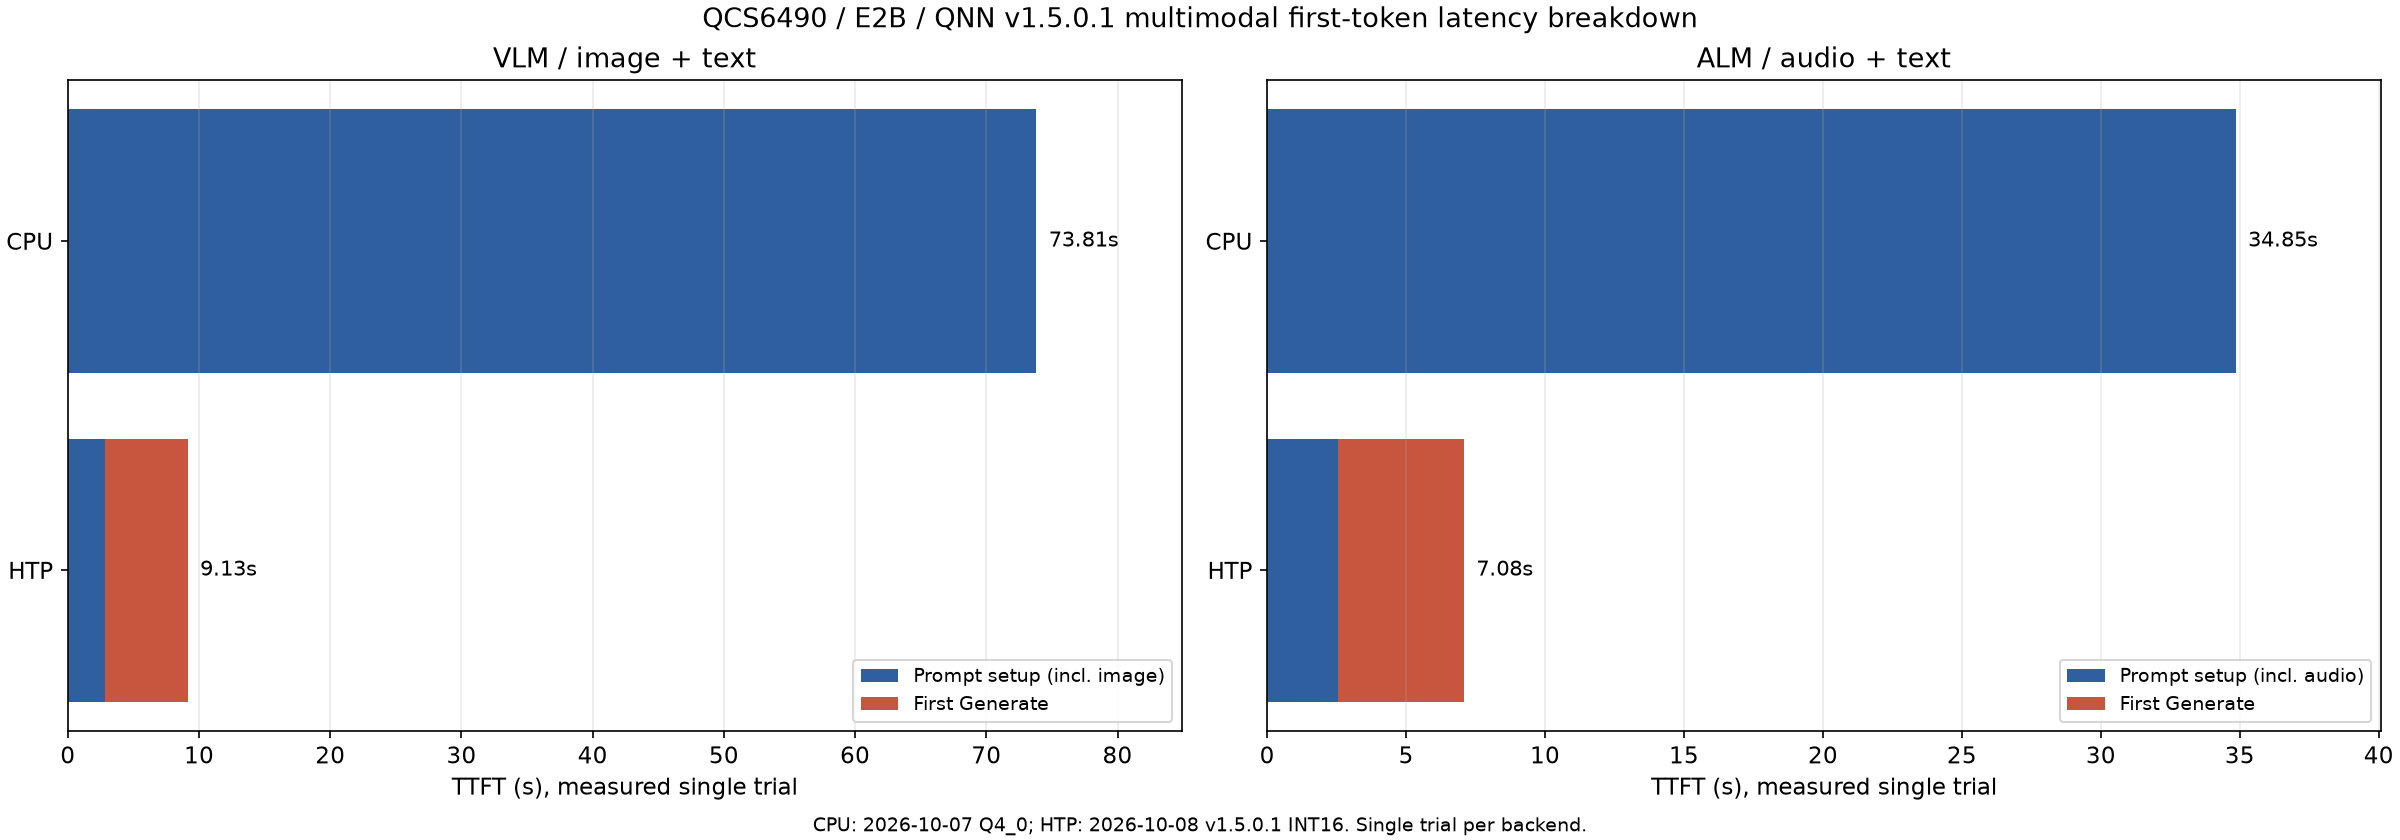
| 入力 | 経路 | TTFT | Decode | 出力トークン数 |
|---|---|---|---|---|
| 画像 | CPU | 73.81 秒 | 8.603 tokens/s | 100 |
| 画像 | NPU(Int16) | 9.13 秒 | 4.361 tokens/s | 100 |
| 音声 | CPU | 34.85 秒 | 9.081 tokens/s | 33 |
| 音声 | NPU(Int16) | 7.08 秒 | 4.373 tokens/s | 33 |
NPU の TTFT は CPU より、画像入力で約 8.1 倍、音声入力で約 4.9 倍高速です。
| 経路 | CPU 使用率 |
|---|---|
| CPU | 49.2% |
| NPU(QNN) | 3.1% |
CPU は高性能コアの 4 コアで実行しているため、CPU の使用率は 50% 前後です。